Ressources & articles IT

Guides pratiques, retours d'expérience et analyses techniques sur la virtualisation, la sauvegarde, le DevOps, l'IA et le développement.

iacybersecuritebusiness

Comment j’ai construit la chaîne éditoriale automatisée de Net&Vous
Comment j’ai construit la chaîne éditoriale automatisée de Net&Vous

Ça faisait un moment que je voulais donner une vraie place à la veille IT dans Net&Vous. Le nouveau site est maintenant en ligne 👉 netetvous.fr En plus de mes services d’infogérance, d’accompagnement IT, automatisation, IA... J’y publierai désormais deux rendez-vous chaque semaine : 🔐 Le lundi soir : la veille cybersécurité Pour retenir l’essentiel des vulnérabilités, CVE, CISA, alertes et incidents qui méritent réellement d’être suivis. 📰 Le mercredi soir : la revue de presse IT Pour faire le point sur les actualités importantes autour de l’infrastructure, du cloud, de l’IA, des logiciels et de la cybersécurité à destination des dirigeants de PME/ETI. L’idée n’est pas d’empiler les liens ou de recopier l’actualité. Je veux surtout faire le tri, apporter du contexte et résumer ce qu’il faut vraiment retenir. 📩 Il est possible de s’abonner par e-mail à l’une des deux publications, ou aux deux. 📡 Et pour ceux qui préfèrent suivre leur veille autrement, un flux RSS est égalem…

Comment j’ai construit la chaîne éditoriale automatisée de Net&Vous

Je viens de mettre en ligne une nouvelle version de Net&Vous, mon site consacré à l’infogérance, à la cybersécurité et à l’accompagnement IT des entreprises.

Mais derrière le site visible se trouve un autre projet qui m’intéresse tout autant : la construction d’une véritable chaîne éditoriale automatisée.

L’objectif était assez simple à formuler : publier régulièrement de la veille IT de qualité sans passer plusieurs heures chaque semaine à collecter, trier, reformater et publier manuellement des dizaines d’informations.

Pour y parvenir, j’ai progressivement construit un système autour de n8n, Strapi et d’un Workflow Manager développé pour piloter toute la partie éditoriale.

Le résultat alimente aujourd’hui deux publications récurrentes sur Net&Vous :

  • une veille cybersécurité chaque lundi soir ;
  • une revue de presse IT chaque mercredi soir.

Et surtout, l’automatisation s’arrête volontairement avant la publication définitive : la sélection et la validation éditoriale restent sous contrôle humain.


Partir de beaucoup d’informations pour n’en garder que quelques-unes

Le principal problème de la veille technologique n’est pas vraiment de trouver de l’information.

C’est plutôt l’inverse.

Nous sommes en permanence confrontés à énormément de sources : avis de sécurité, vulnérabilités, actualités éditeurs, incidents, cloud, intelligence artificielle, infrastructure, logiciels, réglementations, annonces de constructeurs...

Lire tout cela quotidiennement devient rapidement impossible.

Mon objectif avec Net&Vous n’était donc pas de construire un nouvel agrégateur RSS.

Je voulais mettre en place une chaîne capable de :

collecter → filtrer → structurer → sélectionner → enrichir → valider → publier.

L’automatisation devait supprimer les tâches répétitives tout en me laissant la décision finale sur le contenu publié.


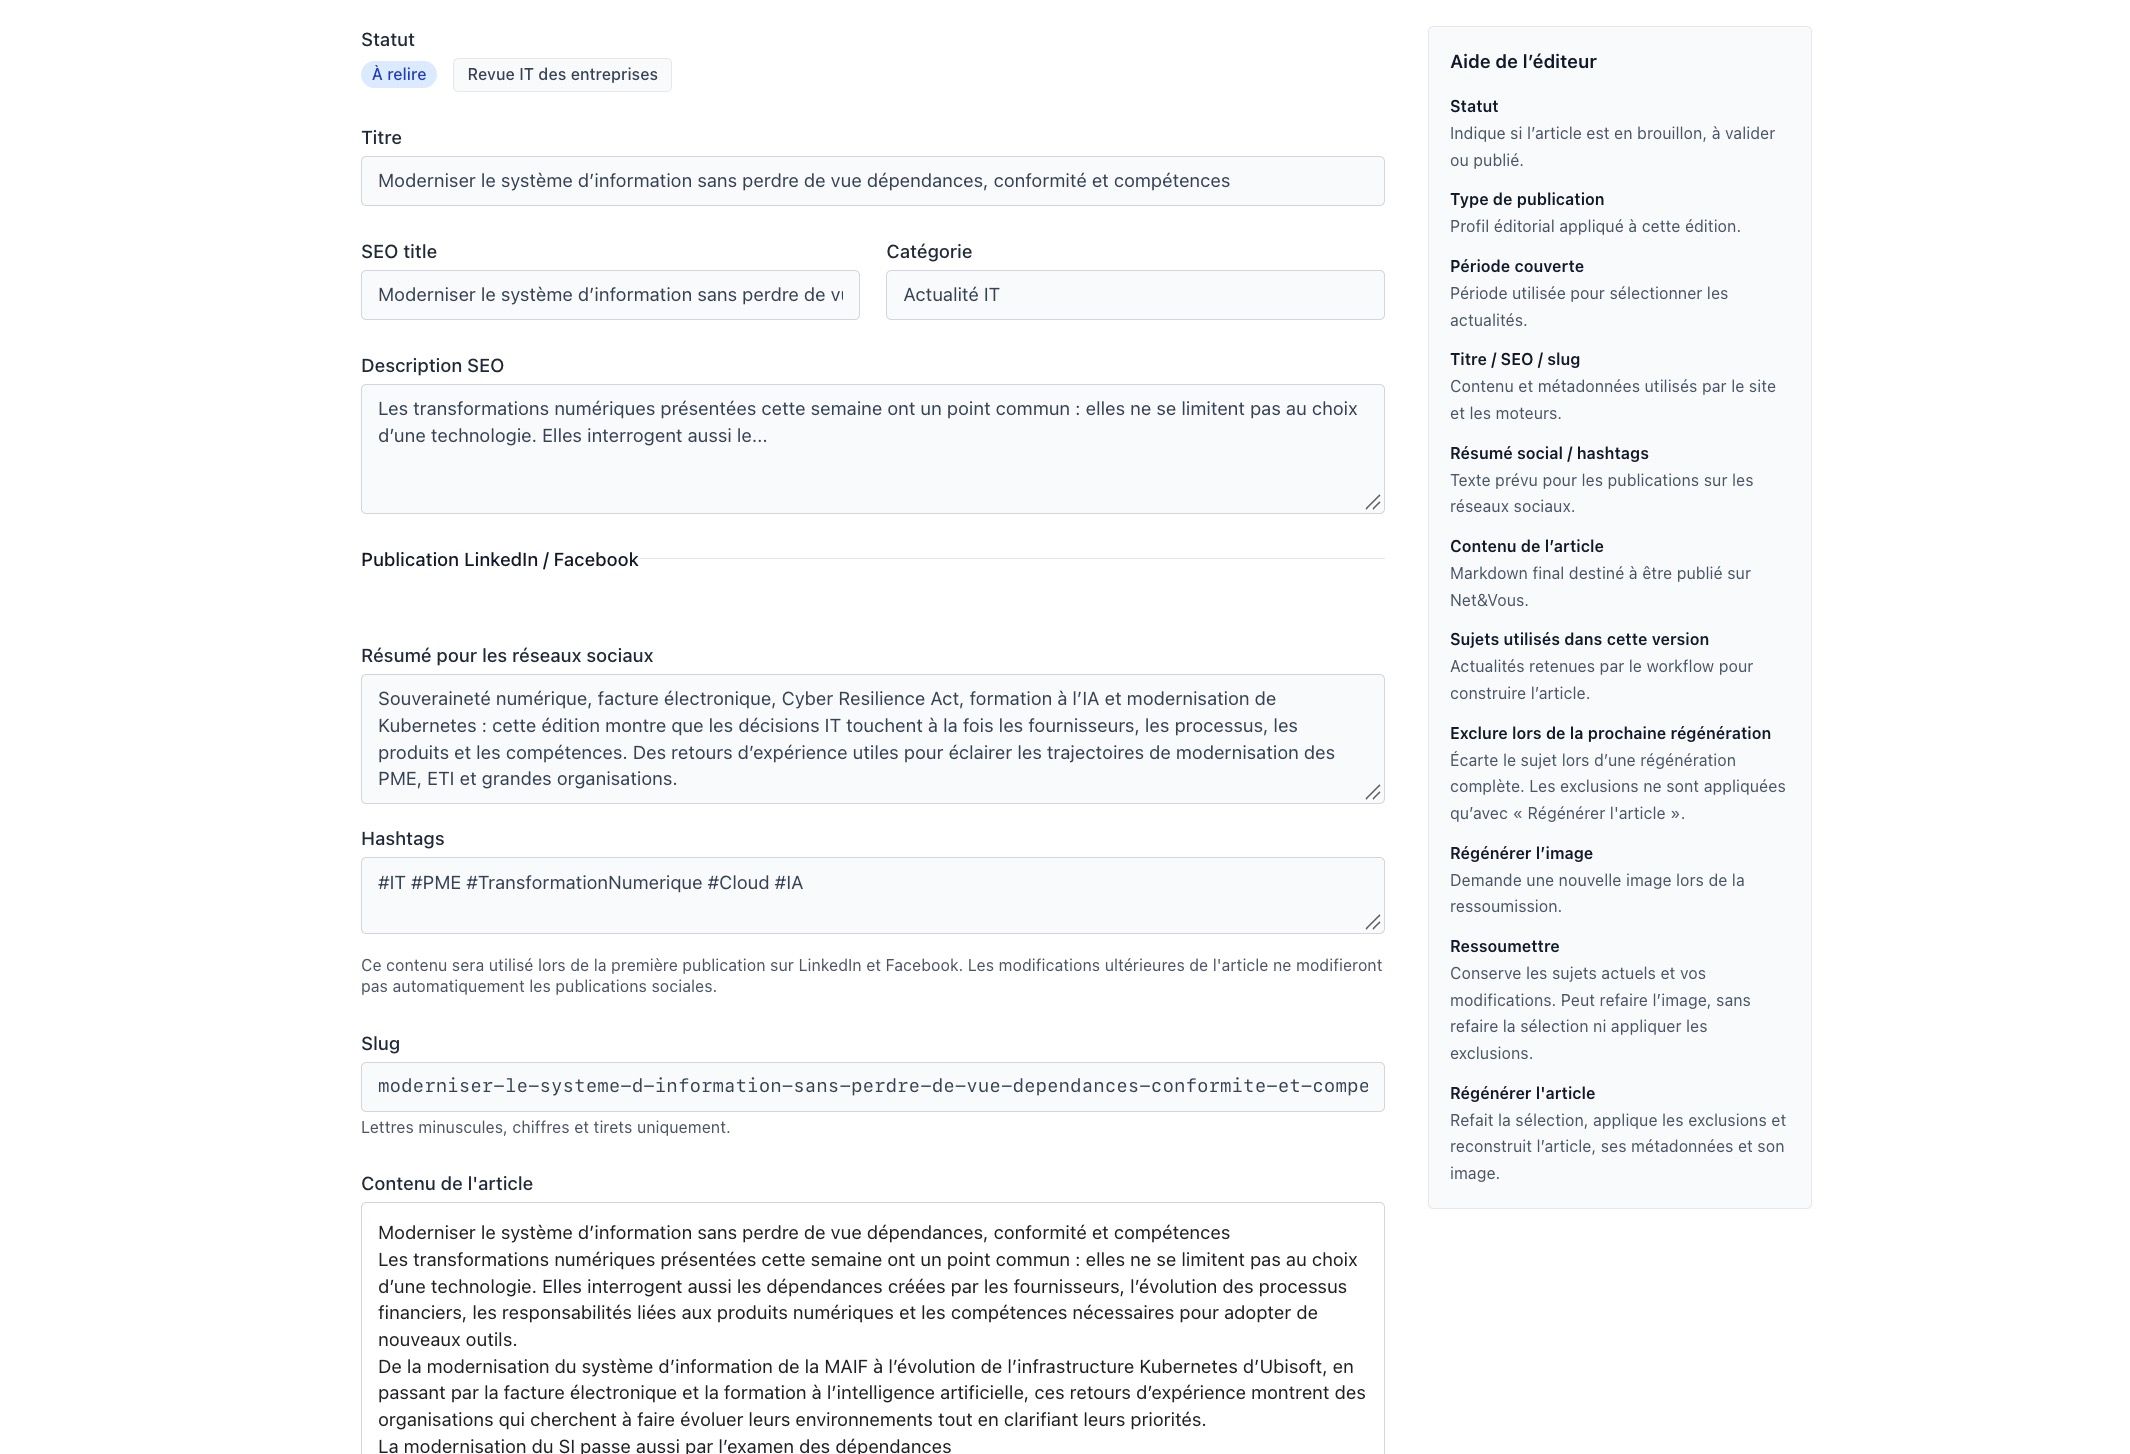
n8n comme moteur d’automatisation

La majeure partie de l’orchestration repose sur n8n.

Plusieurs workflows se chargent de récupérer et de traiter les différentes sources utilisées pour la veille.

Ils permettent notamment d'automatiser les étapes répétitives :

  • récupération des nouvelles publications ;
  • filtrage par date ;
  • élimination d'informations qui ne correspondent pas aux critères éditoriaux ;
  • extraction des métadonnées utiles ;
  • normalisation des informations provenant de sources différentes ;
  • préparation des contenus destinés au système éditorial.

Pour la cybersécurité, par exemple, l'enjeu est rapidement de réduire une quantité importante d'avis et de vulnérabilités à un ensemble réellement intéressant pour le lecteur.

Publier plusieurs centaines de références n'aurait aucun intérêt.

Le but est au contraire de faire ressortir les informations susceptibles d'avoir un véritable impact opérationnel pour une entreprise ou une infrastructure informatique.

Un Workflow Manager pour reprendre la main

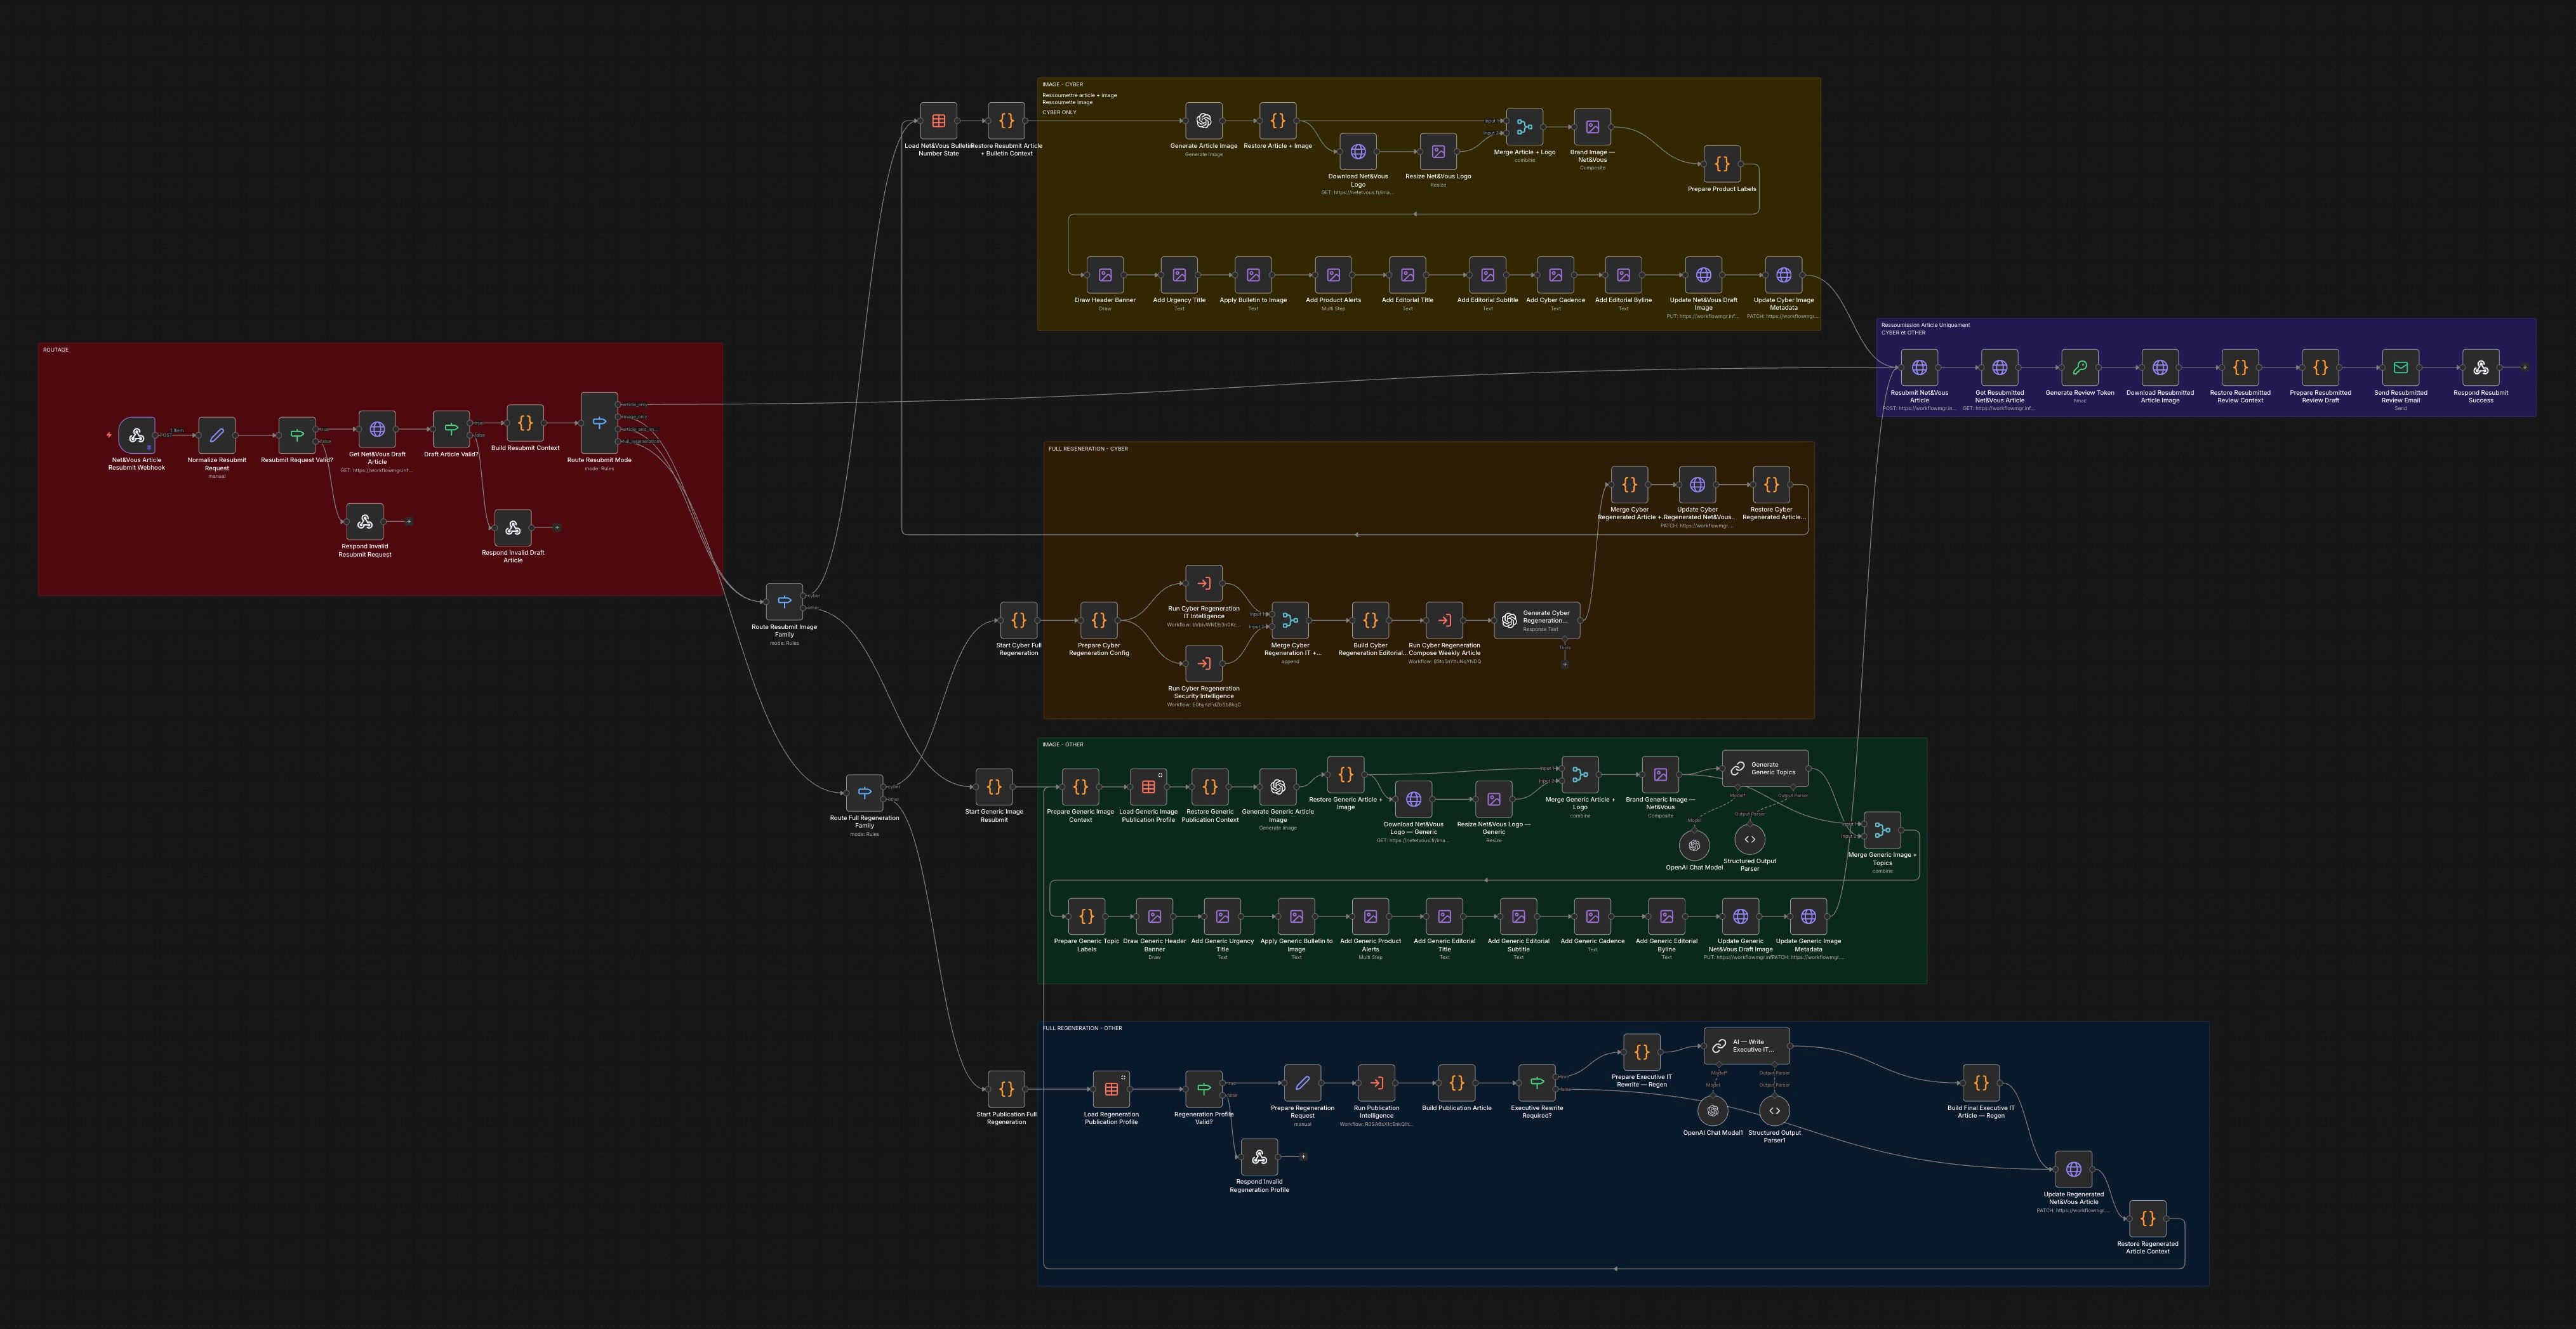
Je ne voulais cependant pas que l'automatisation publie directement ce qu'elle trouvait.

J'ai donc développé un Workflow Manager servant d'interface entre les workflows automatiques et la publication finale.

C'est ici que je retrouve les contenus préparés par les automatisations.

Je peux ensuite les relire, les modifier, les compléter, ajuster leur présentation ou décider simplement de ne pas les publier.

Cette étape est importante.

Une automatisation sait très bien traiter beaucoup de données, appliquer des règles et préparer du contenu.

Elle ne remplace pas pour autant le jugement nécessaire pour décider :

« Est-ce réellement intéressant pour quelqu'un qui va lire cette revue ? »

Le Workflow Manager devient donc en quelque sorte mon poste de contrôle éditorial.

Séparer automatisation et décision éditoriale

C'est probablement l'un des principes les plus importants du projet.

Je ne cherchais pas à construire une usine capable de publier automatiquement vingt articles par jour.

Au contraire.

L'automatisation sert principalement à supprimer le travail qui n'apporte que peu de valeur :

récupérer les données, parcourir les sources, éliminer le bruit, extraire les informations, les organiser et préparer une première structure.

La partie qui reste intéressante reste humaine :

sélectionner, comprendre, contextualiser et décider de publier.

Cette séparation permet également d'éviter un problème fréquent avec les systèmes de génération ou d'agrégation automatique : produire énormément de contenu sans véritable ligne éditoriale.


Strapi comme backend éditorial

Une fois un contenu validé, il rejoint Strapi, qui sert de backend de gestion de contenu.

Cela permet au site Net&Vous de conserver une architecture séparant clairement :

  • la collecte et l'automatisation ;
  • la gestion éditoriale ;
  • le stockage des contenus ;
  • leur présentation sur le site.

Les articles disposent également de leurs informations de classement et de publication afin de pouvoir être exploités par les différentes parties du site.

Cette architecture me permet surtout de faire évoluer indépendamment le moteur de veille, le Workflow Manager ou le frontend sans devoir reconstruire l'ensemble du système.


Une publication ne s'arrête pas au site web

Un autre objectif était de ne pas obliger les lecteurs à revenir régulièrement sur le site pour vérifier si quelque chose avait été publié.

J'ai donc prévu plusieurs modes de diffusion.

Les lecteurs peuvent recevoir les contenus directement par e-mail et choisir ce qui les intéresse :

  • uniquement la veille cybersécurité ;
  • uniquement la revue de presse IT ;
  • ou les deux.

Un flux RSS est également disponible pour ceux qui utilisent déjà leur propre système de veille.

La logique est volontairement simple : le contenu doit pouvoir arriver là où le lecteur préfère le consommer.


Deux rendez-vous chaque semaine

Cette infrastructure sert aujourd'hui deux publications principales.

Le lundi soir : veille cybersécurité

Cette publication se concentre sur les vulnérabilités, alertes, incidents et événements cyber intéressants de la période.

Le but n'est pas simplement de reprendre des références techniques.

J'essaie surtout de répondre aux questions qui comptent réellement :

Que s'est-il passé ? Qui peut être concerné ? Pourquoi est-ce important ? Faut-il surveiller ou agir ?

Le mercredi soir : revue de presse IT

La seconde publication élargit le périmètre à l'actualité informatique :

infrastructure, cloud, cybersécurité, intelligence artificielle, éditeurs, logiciels, technologies et évolutions du secteur.

Là encore, le principe est le même : réduire le bruit sans perdre l'information importante.


Construire un système plutôt qu'effectuer une tâche

C'est probablement ce que je trouve le plus intéressant dans ce projet.

Il aurait été beaucoup plus rapide de publier manuellement une première revue de presse.

Mais il aurait ensuite fallu recommencer exactement le même travail la semaine suivante.

Puis encore la semaine d'après.

J'ai préféré investir ce temps dans la construction d'un système capable de reproduire toute la partie mécanique du processus.

Cela demande davantage de travail au départ, mais change complètement la manière d'aborder la tâche ensuite.

Et cette logique dépasse largement le cas d'une revue de presse.

C'est exactement ce que je recherche aujourd'hui dans beaucoup de projets d'automatisation :

identifier les opérations répétitives, les transformer en workflows fiables, puis conserver l'humain là où sa décision apporte réellement de la valeur.


Et maintenant ?

Le système va évidemment continuer à évoluer.

Les workflows seront ajustés au fur et à mesure des publications, de nouvelles sources pourront être ajoutées et les critères de sélection seront affinés en fonction de la qualité des résultats.

Mais la première version est maintenant opérationnelle.

Vous pouvez retrouver les publications directement sur :

netetvous.fr

Et pour ma part, je continuerai également à partager ici, sur InforConsult, les coulisses plus techniques de ce type de projets : n8n, automatisation, infrastructure, développement et architecture des outils que je mets en place.
Entrepreneurs à Perpignan : un nouveau groupe BNI est en cours de création

Entrepreneurs à Perpignan : un nouveau groupe BNI est en cours de création

Vous êtes entrepreneur, indépendant, dirigeant ou profession libérale dans les Pyrénées-Orientales ? Un nouveau groupe BNI est actuellement en cours de création dans la région de Perpignan, avec plusieurs professions encore recherchées. Le principe du BNI est assez simple : réunir régulièrement des professionnels de métiers différents afin qu’ils apprennent à se connaître, comprennent leurs activités respectives et puissent se recommander auprès de leur propre réseau. Ce n’est donc pas simplement un endroit où distribuer des cartes de visite : l’objectif est de construire progressivement un réseau de confiance capable de générer des recommandations et des opportunités commerciales. J’ai moi-même récemment découvert le fonctionnement du réseau et je vais participer à une réunion de présentation du nouveau groupe en constitution. Si vous êtes entrepreneur dans le secteur de Perpignan et que le sujet vous intéresse, vous pouvez me contacter directement. Je pourrai vous mettre en rela…

Qu'est-ce qu'un groupe BNI ?

BNI, pour Business Network International, est un réseau professionnel fondé sur le principe de la recommandation d'affaires.

Contrairement à une rencontre professionnelle ponctuelle où chacun échange quelques cartes de visite, un groupe BNI réunit régulièrement les mêmes entrepreneurs et professionnels.

L'idée est simple : à force de se rencontrer, les membres apprennent réellement à connaître les activités des autres, leurs clients, leurs compétences et le type de personnes qu'ils recherchent.

Cela permet ensuite de faire quelque chose de beaucoup plus intéressant qu'un simple échange de coordonnées : recommander un membre de son groupe lorsqu'une opportunité se présente dans son propre réseau.

BNI résume cette philosophie par le principe « Qui donne reçoit » : chacun contribue au développement du réseau en aidant les autres membres à obtenir des mises en relation et des recommandations. https://bnifrance.fr/fr/bni

Comment fonctionne concrètement un groupe ?

Les groupes BNI se réunissent généralement chaque semaine.

Chaque membre dispose notamment de temps pour présenter son activité, expliquer ce qu'il recherche et aider les autres membres à mieux identifier les situations dans lesquelles ils peuvent le recommander. https://bnifrance.fr/fr/rejoindre-bni

L'une des particularités du modèle est que chaque profession n'est représentée qu'une seule fois au sein d'un groupe.

Par exemple, si le groupe possède déjà un expert-comptable représentant cette activité, un deuxième expert-comptable ne viendra normalement pas occuper exactement la même catégorie professionnelle.

Cela évite d'avoir plusieurs concurrents directs autour de la même table et permet à chaque membre de devenir le contact identifié du groupe pour son domaine d'activité.

Quel intérêt pour un entrepreneur ?

Le premier bénéfice est évidemment le développement commercial.

Imaginez un groupe composé d'un assureur, d'un avocat, d'un agent immobilier, d'un expert-comptable, d'un professionnel du bâtiment, d'un consultant informatique, d'un courtier, d'un photographe, etc.

Chacun rencontre régulièrement des clients, fournisseurs et partenaires.

Lorsqu'un client dit :

« Je cherche quelqu'un pour refaire le réseau informatique de mon entreprise »

ou :

« Vous connaissez un bon courtier ? »

le membre du groupe peut directement mettre les deux personnes en relation.

Votre réseau commercial ne repose donc plus uniquement sur vos propres contacts : progressivement, les autres membres deviennent eux aussi capables d'identifier des opportunités pour vous.

BNI revendique aujourd'hui plus de 15 000 membres en France et plusieurs centaines de milliers de recommandations échangées, même si ces chiffres sont issus de données déclaratives du réseau lui-même. https://www.bni.com/country/france/

Mais le véritable intérêt est aussi ailleurs

Pour beaucoup d'entrepreneurs, notamment les indépendants et les petites entreprises, la prospection commerciale est compliquée.

Il faut trouver les bons interlocuteurs, obtenir leur confiance puis réussir à décrocher un rendez-vous.

La recommandation change complètement cette dynamique.

Une introduction du type :

« Je connais quelqu'un qui pourrait vous aider, je vais vous mettre en relation »

n'a évidemment pas la même valeur qu'un email envoyé à froid à une entreprise qui ne vous connaît pas.

Le réseau peut également permettre de nouer des partenariats entre métiers complémentaires, de mieux connaître l'écosystème économique local et simplement de rencontrer régulièrement d'autres dirigeants confrontés aux mêmes problématiques entrepreneuriales.

Un nouveau groupe est justement en création à Perpignan

C'est la raison pour laquelle je souhaitais parler du sujet aujourd'hui.

Un nouveau groupe BNI est actuellement en cours de constitution dans la région de Perpignan.

La création d'un groupe passe justement par une phase durant laquelle un premier noyau de professionnels est constitué avant le lancement définitif du groupe. BNI distingue officiellement les groupes « en projet », « en création » puis les groupes actifs. https://bnifrance.fr/fr/pourquoibni

C'est donc une période assez intéressante pour les entrepreneurs qui souhaitent découvrir le fonctionnement du réseau, puisque de nombreuses professions peuvent encore être représentées.

De mon côté, je m'intéresse au groupe dans le cadre du développement de mon activité d'infogérance et de services informatiques pour les entreprises.

Et plutôt que de garder l'information uniquement pour moi, je me suis dit qu'elle pouvait également intéresser d'autres entrepreneurs de la région.

Vous souhaitez en savoir plus ?

Si vous êtes entrepreneur, indépendant, dirigeant, commerçant, artisan ou profession libérale autour de Perpignan et que vous souhaitez développer votre réseau professionnel, cela peut être l'occasion de découvrir le fonctionnement du BNI.

Je ne suis évidemment pas organisateur du réseau BNI : je participe moi-même à la démarche en tant qu'entrepreneur.

Mais si le sujet vous intéresse, envoyez-moi simplement un message.

Je pourrai vous transmettre les informations dont je dispose et, si cela correspond à votre activité, vous mettre en relation avec les personnes qui travaillent actuellement à la constitution du nouveau groupe.

Même si vous ne connaissez absolument pas BNI, ce n'est pas un problème : le plus simple reste probablement de venir voir comment cela fonctionne.

ia

⚠️ Vous êtes en recherche d’emploi ou de mission ? Soyez particulièrement vigilants face aux faux recruteurs.

⚠️ Vous êtes en recherche d’emploi ou de mission ? Soyez particulièrement vigilants face aux faux recruteurs.

Depuis hier, j’ai reçu deux emails provenant de prétendus recruteurs, me proposant un échange à 18h30 et reprenant plusieurs éléments précis de mon CV afin de rendre leur approche crédible. À première vue, le message pourrait facilement passer pour une sollicitation classique. En recherchant simplement l’adresse email de l’expéditeur sur Google, j’ai toutefois constaté que plusieurs autres candidats venaient de recevoir exactement le même type de message. Autre élément qui m’a immédiatement alerté : l’adresse utilisée était une adresse @gmail.com, alors que l’expéditeur prétendait intervenir dans le cadre d’un recrutement pour une grande entreprise. 🚩 Ce n’est pas nécessairement une preuve de fraude à elle seule, mais c’est clairement un signal d’alerte qui doit pousser à effectuer quelques vérifications. Ce genre de campagne est aujourd’hui particulièrement simple à industrialiser. Avec l’IA et des outils d’automatisation comme n8n, Make ou d’autres plateformes de workflow, il…

backup

J'ai mis en ligne un diagnostic informatique gratuit en 3 minutes pour les dirigeants de PME/ETI

J'ai mis en ligne un diagnostic informatique gratuit en 3 minutes pour les dirigeants de PME/ETI

📊 "On a un antivirus, une sauvegarde... on doit être à peu près protégés." C'est ce que pensent la plupart des dirigeants de PME que je rencontre. Et la plupart du temps, personne n'a vraiment vérifié. Je viens de mettre en ligne un outil gratuit qui répond à cette question en 3 minutes chrono : un diagnostic de votre parc informatique (sauvegarde, sécurité, supervision, budget), qui vous donne un score, vos points de fragilité prioritaires et des conseils concrets pour les corriger, gratuitement, sans rendez-vous, sans carte bancaire, sans engagement. C'est le point de départ que j'aurais aimé donner à chaque PME avant qu'un incident ne les force à se poser la question.

Le problème : personne ne vérifie, jusqu'au jour où ça casse

Dans la plupart des PME que j'accompagne ou que je rencontre, la question "êtes-vous bien protégés informatiquement ?" reçoit une réponse honnête mais floue : "je crois", "normalement oui", "je ne sais pas trop, c'est mon prestataire qui gère". Personne n'a de mauvaise volonté, c'est juste qu'aucun outil simple ne permettait jusqu'ici de faire le point sans déjà s'engager dans un audit complet.

L'outil : un diagnostic en 3 minutes, pas un audit déguisé

C'est pour ça que j'ai construit ce diagnostic, accessible sur infogerance.inforconsult.fr. Le principe : une quinzaine de questions simples (à choix, pas de champ à remplir), sur quatre thèmes :

  • votre profil (taille de l'équipe, nombre de postes et de serveurs) ;
  • votre sauvegarde (automatique ? protégée contre le ransomware ? déjà testée ?) ;
  • votre sécurité (antivirus, mises à jour, double authentification) ;
  • votre support actuel (supervision proactive ou découverte des pannes après coup, délai d'intervention).

À la fin, deux scores s'affichent immédiatement : un score sécurité et un score de clarté budgétaire, sans même avoir donné d'email. Ce n'est qu'ensuite, pour débloquer le détail (points d'attention prioritaires et conseils concrets pour progresser), qu'un prénom et un email sont demandés.

Ce n'est pas un audit réel, et c'est assumé

Ce diagnostic ne remplace pas un vrai audit informatique. C'est un déclaratif : les réponses reposent sur ce que vous savez de votre parc, pas sur une inspection technique. Mais c'est justement là son intérêt : donner en 3 minutes une première photo honnête, là où un audit complet demande du temps et un rendez-vous. Le diagnostic débouche d'ailleurs naturellement vers l'audit gratuit que je propose déjà, sur site ou à distance, pour ceux qui veulent aller plus loin.

Pourquoi je le rends public maintenant

Beaucoup de dirigeants de PME reportent la question de la sécurité informatique parce qu'ils n'ont pas de point de départ clair : pas envie de prendre un rendez-vous juste pour "voir", pas le temps de creuser seul. Ce diagnostic supprime cette première friction, et surtout, il ne vend rien. Pas de tarif affiché, pas de forfait poussé en fin de parcours : uniquement des conseils concrets et gratuits, adaptés à vos réponses, pour améliorer dès aujourd'hui ce qui peut l'être par vous-même (activer une double authentification, tester une restauration, revoir la fréquence de vos sauvegardes...).

Envie de savoir où vous en êtes, en 3 minutes et sans engagement ? Le diagnostic est accessible ici : https://infogerance.inforconsult.fr/ . Il vous dira exactement où sont vos points de fragilité, avant qu'un incident ne s'en charge à votre place.

backupdevopsvirtualisation

Ce que les pratiques SRE des grands comptes peuvent apprendre à n'importe quelle PME

Ce que les pratiques SRE des grands comptes peuvent apprendre à n'importe quelle PME

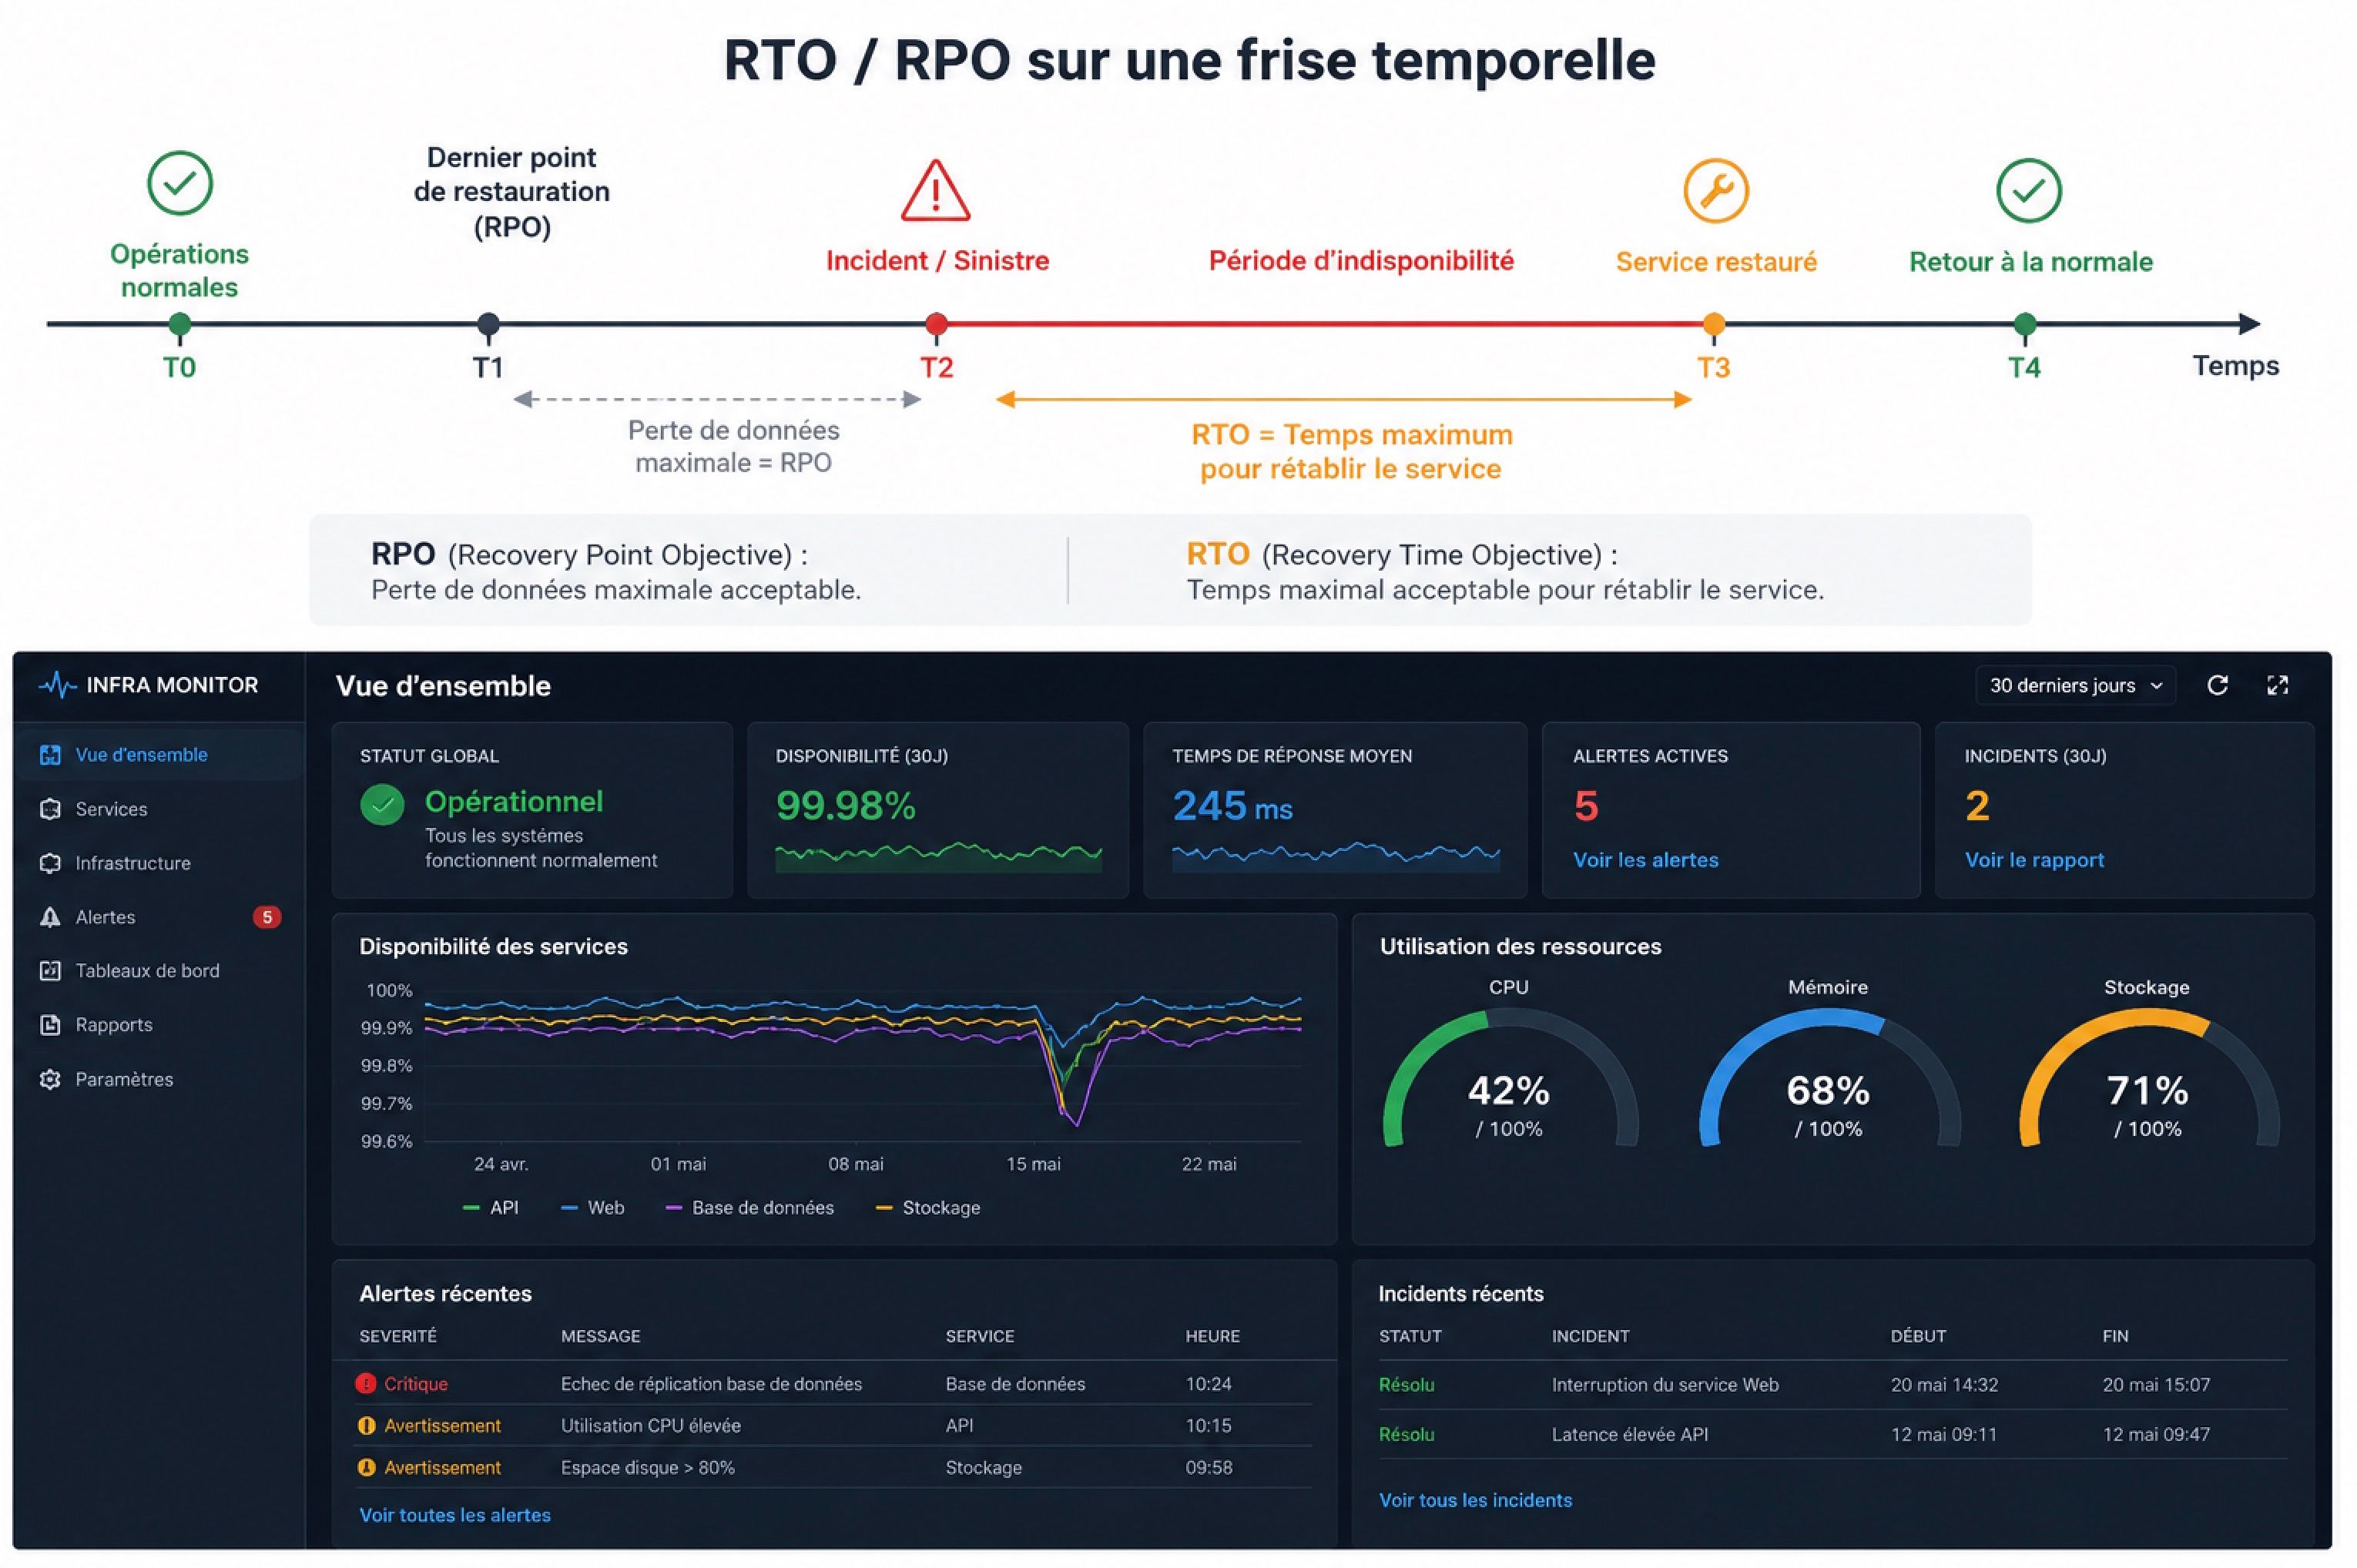
⚙️ SRE, PRA, RTO, RPO... Des acronymes qu'on associe plutôt aux grandes infrastructures cloud. Et pourtant, les principes qui sont derrière sont exactement les mêmes qui devraient guider la résilience informatique d'une PME de 10 postes. On n'a pas besoin d'un cluster Kubernetes multi-région pour appliquer une logique de résilience sérieuse. On a juste besoin de se poser les bonnes questions — celles que les équipes SRE se posent tous les jours sur des systèmes critiques.

SRE : une discipline née pour la haute disponibilité, utile bien au-delà

Le Site Reliability Engineering (SRE) est une discipline qui vise à garantir la fiabilité de systèmes complexes, en s'appuyant sur des objectifs mesurables plutôt que sur des impressions. Deux notions structurent cette approche : le RTO (Recovery Time Objective — combien de temps on accepte d'être arrêté) et le RPO (Recovery Point Objective — combien de données on accepte de perdre).

Ces deux questions ne sont pas réservées aux infrastructures cloud à grande échelle. Elles s'appliquent, avec le même bon sens, à un serveur de PME

Se poser la question du RTO avant la panne, pas pendant

Combien de temps une PME peut-elle tenir sans son serveur de facturation ? Une heure ? Une journée ? La réponse conditionne directement le niveau d'investissement à prévoir en matière de redondance et de plan de reprise. Beaucoup d'entreprises n'ont tout simplement jamais formulé cette réponse — et découvrent leur véritable tolérance au pire moment.

Se poser la question du RPO pour dimensionner la fréquence de sauvegarde

Le RPO détermine la fréquence de sauvegarde nécessaire. Perdre une heure de données n'a pas le même impact que perdre une journée. C'est ce paramètre, plus que la technologie choisie, qui doit piloter la stratégie de sauvegarde.

Le PRA : formaliser ce qui reste souvent implicite

Un Plan de Reprise d'Activité (PRA) documente noir sur blanc : qui fait quoi, dans quel ordre, avec quels accès, en cas d'incident majeur. Sur les grandes infrastructures, ce plan est testé régulièrement — chaos engineering, exercices de bascule planifiés. Sur les PME, il est souvent absent, ou resté dans la tête d'une seule personne. Le jour où cette personne est indisponible, l'entreprise découvre le vrai coût de l'absence de formalisation.

Une discipline transposable, à l'échelle d'une PME

Il ne s'agit pas de déployer les mêmes outils qu'un grand compte, mais d'appliquer la même rigueur : objectifs mesurables, tests réguliers, documentation à jour. C'est une bonne partie du travail mené en parallèle sur des infrastructures cloud critiques (Terraform, Kubernetes, AWS) qui vient nourrir la façon dont Inforconsult structure la résilience des systèmes d'information des PME accompagnées.

Apple Studio Display en dual screen windows/mac, ça marche !

Apple Studio Display en dual screen windows/mac, ça marche !

Pendant plusieurs mois, j'ai cherché ce qui semblait être le KVM idéal pour mon environnement de travail... sans succès. Mon besoin était pourtant assez simple sur le papier : - un Mac Studio pour mon activité principale ; - un PC Windows professionnel administré par un client ; - un seul écran : Apple Studio Display ; - un seul clavier et une seule souris. En pratique, c'est devenu un véritable casse-tête. L'Apple Studio Display est un excellent écran, mais il est très particulier : Thunderbolt uniquement, webcam, micros, haut-parleurs, ports USB intégrés... Peu de KVM savent gérer correctement tout cela. Après beaucoup de recherches, je suis finalement tombé sur le Sabrent Thunderbolt 4 KVM (SB-TB4K). Le problème ? Impossible à trouver en Europe. J'ai fini par en importer un des États-Unis après plusieurs tentatives infructueuses (ruptures de stock, vendeurs ne livrant pas en France, etc.). Après plusieurs jours de tests, le verdict est très positif. Ce qui fonctionne parfai…

cloudbackupdevopsiavirtualisation

Je suis informaticien !

Je suis informaticien !

Je vois souvent passer des publications qui expliquent que : ❌ « Informaticien, ça n'existe pas. » ❌ « L'informatique n'est pas un métier. » ❌ « Il faut dire DevOps, SRE, Cloud Engineer, Platform Engineer, Data Scientist, etc. » Honnêtement, je me présente souvent comme « informaticien ». Pourquoi ? Parce que la plupart des gens s'en fichent. Quand quelqu'un me demande ce que je fais, ce n'est généralement pas pour connaître mon périmètre Kubernetes, mon niveau d'expertise sur Ansible ou si je suis plus orienté infrastructure que réseau. C'est juste du small talk. Et je ne vais pas répondre : ☁️ Architecte Infrastructure spécialisé dans les environnements hybrides, l'automatisation, les plateformes de données et les systèmes distribués. Je dis : 💻 « Je travaille dans l'informatique. » Comme quelqu'un dira : 🏥 « Je travaille dans la santé. » 🏗️ « Je travaille dans le bâtiment. » ⚖️ « Je travaille dans le juridique. » Si la personne est réellement intéressée, alors on ren…

backupclouddevopsiavirtualisation

🚀 Vous êtes ingénieur, administrateur système, expert cloud ou architecte IT ?

🚀 Vous êtes ingénieur, administrateur système, expert cloud ou architecte IT ?

Je développe actuellement un réseau de consultants indépendants spécialisés dans les domaines suivants : ✅ Infrastructure ✅ Cloud ✅ VMware / Proxmox ✅ Stockage ✅ Backup & Disaster Recovery ✅ Linux / Windows ✅ DevOps ✅ Cybersécurité L'objectif est simple : partager des opportunités de mission et mettre en relation les bons profils avec les bonnes entreprises. Je suis particulièrement intéressé par les profils expérimentés (5+ ans d'expérience), qu'ils soient déjà freelances ou salariés. 👉 Vous êtes salarié et vous envisagez de passer freelance, mais vous avez des questions ? Je peux également partager mon retour d'expérience sur : • La création d'entreprise (EURL, SASU, etc.) • Le choix du statut juridique • La comptabilité et les outils de gestion • La recherche de missions • Les TJM et la négociation • La transition du salariat vers l'indépendance • Les erreurs à éviter lors du démarrage Ces échanges sont totalement gratuits. L'objectif est avant tout de développer mon réseau…

📅 Pour celles et ceux qui souhaitent échanger sur le freelancing, la création d'entreprise ou le développement de leur activité, vous pouvez réserver directement un créneau de 30 minutes ici :

https://calendly.com/pme-inforconsult/30min

Les échanges sont gratuits et sans engagement.

ia

220 000 GPU : ce que révèle vraiment l’annonce Anthropic x SpaceX

220 000 GPU : ce que révèle vraiment l’annonce Anthropic x SpaceX

Anthropic vient d’annoncer ce soir un partenariat stratégique avec SpaceX pour utiliser toute la capacité de calcul de leur datacenter Colossus 1. Quelques chiffres annoncés : - plus de 300 MW de capacité supplémentaire ; - plus de 220 000 GPU NVIDIA ; - augmentation immédiate des limites Claude Code et API Opus. Mais derrière cette annonce, le vrai sujet est ailleurs. L’IA n’est plus seulement une bataille de modèles. C’est désormais une bataille : - d’énergie, - d’infrastructure, - de GPU, - de réseau, - et de souveraineté. Anthropic parle déjà : - de plusieurs gigawatts de compute avec Amazon et Google ; - de dizaines de milliards investis dans les infrastructures IA ; - et même d’un intérêt pour du “orbital AI compute” avec SpaceX. On est en train de passer d’une logique “startup IA” à une logique d’industrie lourde. Les impacts vont être majeurs sur : - les coûts cloud ; - les architectures hybrides ; - la souveraineté des données ; - et les infrastructures d’entreprise.…

  • Anthropic, SpaceX et la nouvelle guerre mondiale du compute IA

Le 6 mai 2026, Anthropic a annoncé un partenariat majeur avec SpaceX visant à utiliser l’intégralité de la capacité du datacenter Colossus 1.

L’annonce paraît technique au premier abord. En réalité, elle révèle un changement beaucoup plus profond dans l’industrie de l’intelligence artificielle.

Nous ne sommes plus dans une simple course aux modèles. Nous sommes désormais dans une course mondiale au compute.

Une annonce qui dépasse largement Claude

Officiellement, Anthropic communique sur : l’augmentation des limites d’utilisation de Claude ;

  • l’amélioration de Claude Code ;
  • et l’augmentation des quotas API Opus.

Mais ces améliorations ne sont qu’une conséquence visible d’un problème beaucoup plus structurel : la demande en puissance de calcul explose à une vitesse jamais vue.

L’élément clé de l’annonce est celui-ci :

  • plus de 300 MW de capacité supplémentaire ;
  • plus de 220 000 GPU NVIDIA.

Pour donner un ordre d’idée : 300 MW représente la consommation électrique d’une ville moyenne.

On change complètement d’échelle.

L’IA devient une problématique énergétique

Pendant longtemps, les limites de l’informatique étaient principalement :

  • le CPU ;
  • la RAM ;
  • le stockage ;
  • ou le réseau.

Avec l’IA générative, le facteur limitant devient désormais :

  • l’électricité ;
  • le refroidissement ;
  • l’accès aux GPU ;
  • et la densité des infrastructures.

Les modèles modernes nécessitent des clusters gigantesques :

  • réseaux ultra basse latence ;
  • NVLink et InfiniBand ;
  • refroidissement liquide ;
  • alimentation redondée ;
  • stockage distribué massif.

Les annonces se comptent maintenant en gigawatts.

Anthropic mentionne notamment :

  • jusqu’à 5 GW avec Amazon ;
  • 5 GW avec Google/Broadcom ;
  • 30 milliards de dollars de capacité Azure ;
  • 50 milliards investis avec Fluidstack.

L’IA devient progressivement une industrie lourde.

Pourquoi SpaceX est un partenaire logique

L’association entre Anthropic et SpaceX peut sembler surprenante.

En réalité, elle est cohérente.

SpaceX possède :

  • une capacité industrielle énorme ;
  • une expertise énergétique ;
  • des infrastructures réseau mondiales via Starlink ;
  • et une vitesse d’exécution très supérieure aux acteurs traditionnels.

Le point le plus intéressant reste probablement la mention d’un intérêt pour du “orbital AI compute”.

Autrement dit : des infrastructures de calcul IA potentiellement déployées en orbite.

Cela peut sembler futuriste, mais plusieurs problématiques pourraient pousser dans cette direction :

  • accès énergétique ;
  • refroidissement ;
  • résilience ;
  • indépendance géopolitique ;
  • connectivité mondiale.

Souveraineté et conformité deviennent critiques

Anthropic insiste également sur :

  • la résidence des données ;
  • les besoins des secteurs régulés ;
  • et le déploiement d’infrastructures en Europe et en Asie.

Cela confirme une tendance forte : les entreprises veulent davantage de maîtrise sur :

  • la localisation des données ;
  • les flux IA ;
  • les dépendances cloud ;
  • et les contraintes réglementaires.

Pour les architectes infrastructure et cloud, cela va profondément transformer :

  • les stratégies hybrides ;
  • le FinOps ;
  • la gestion énergétique ;
  • la gouvernance des workloads IA ;
  • et les architectures multi-régions.

Le compute devient une ressource stratégique

Le point central de cette annonce est probablement celui-ci :

Le compute devient une ressource stratégique mondiale.

La compétition ne se joue plus uniquement sur :

  • les modèles ;
  • les algorithmes ;
  • ou les produits.

Elle se joue maintenant sur :

  • l’énergie ;
  • les GPU ;
  • les chaînes d’approvisionnement ;
  • les datacenters ;
  • et les infrastructures réseau mondiales.

L’IA rapproche progressivement l’informatique :

  • des télécoms ;
  • de l’énergie ;
  • et des infrastructures critiques nationales.

Nous sommes probablement au début d’une nouvelle phase de l’industrie technologique : celle de l’industrialisation massive du compute IA.

Source officielle : Anthropic – Higher usage limits for Claude and a compute deal with SpaceX

Je participe à la journée SKL EXPERIENCE le 30 mai à Paris

Je participe à la journée SKL EXPERIENCE le 30 mai à Paris

Le 30 mai je participerai à la journée SKL EXPERIENCE, une journée entière dédiée à la croissance et au networking ! Au programme de cette journée organisée par le SKL CLUB™ : des masterclass, des conférences, des tables rondes, avec des invités exceptionnels comme Tony Parker, Jean-Pierre Nadir et bien-sûr Éric Larchevêque. Mais aussi Aurélien De Nunzio, Charles Baras et toute l'équipe SKL CLUB™. Ce type de journée c'est l'occasion de prendre de la hauteur sur son activité, de sortir la tête du guidon et de se nourrir de l'expérience des autres ! C'est aussi (et peut-être surtout) l'opportunité de rencontrer d'autres entrepreneurs qui partagent les mêmes ambitions, les mêmes doutes et la même envie d'aller plus loin. Hâte d'échanger avec vous avant, pendant et après l'évènement ! 🙃 Il reste des places pour s'inscrire, rejoignez-moi à cet événement : https://luma.com/tq13smnp

devopscloudapp

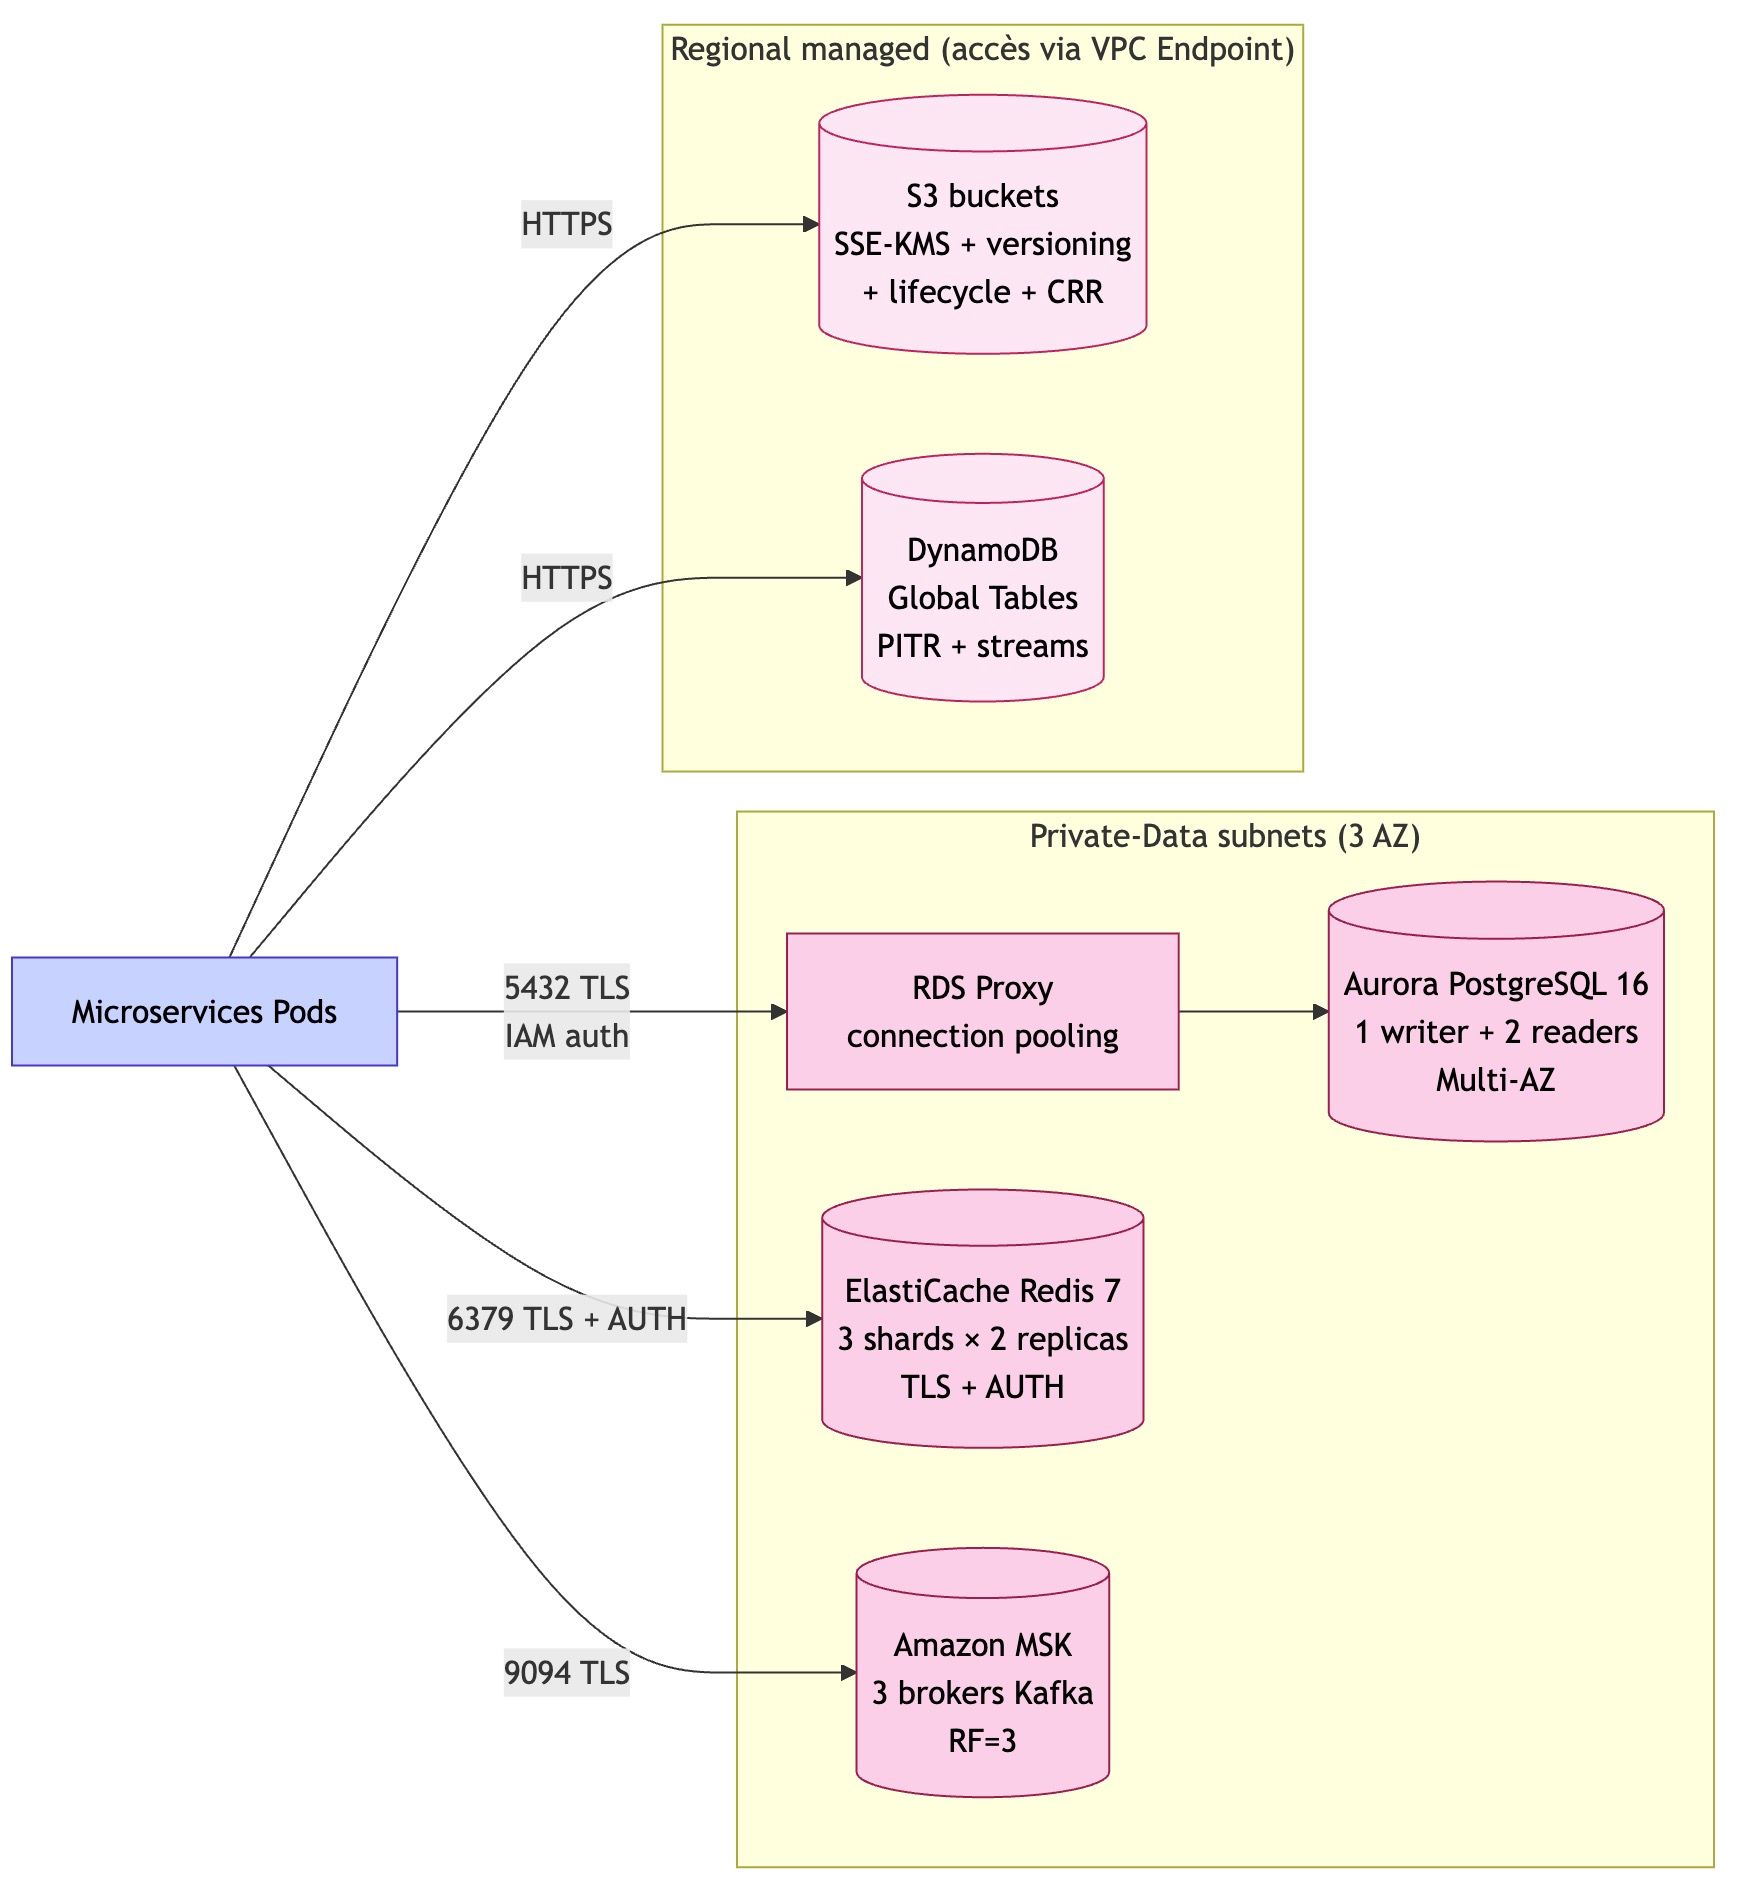
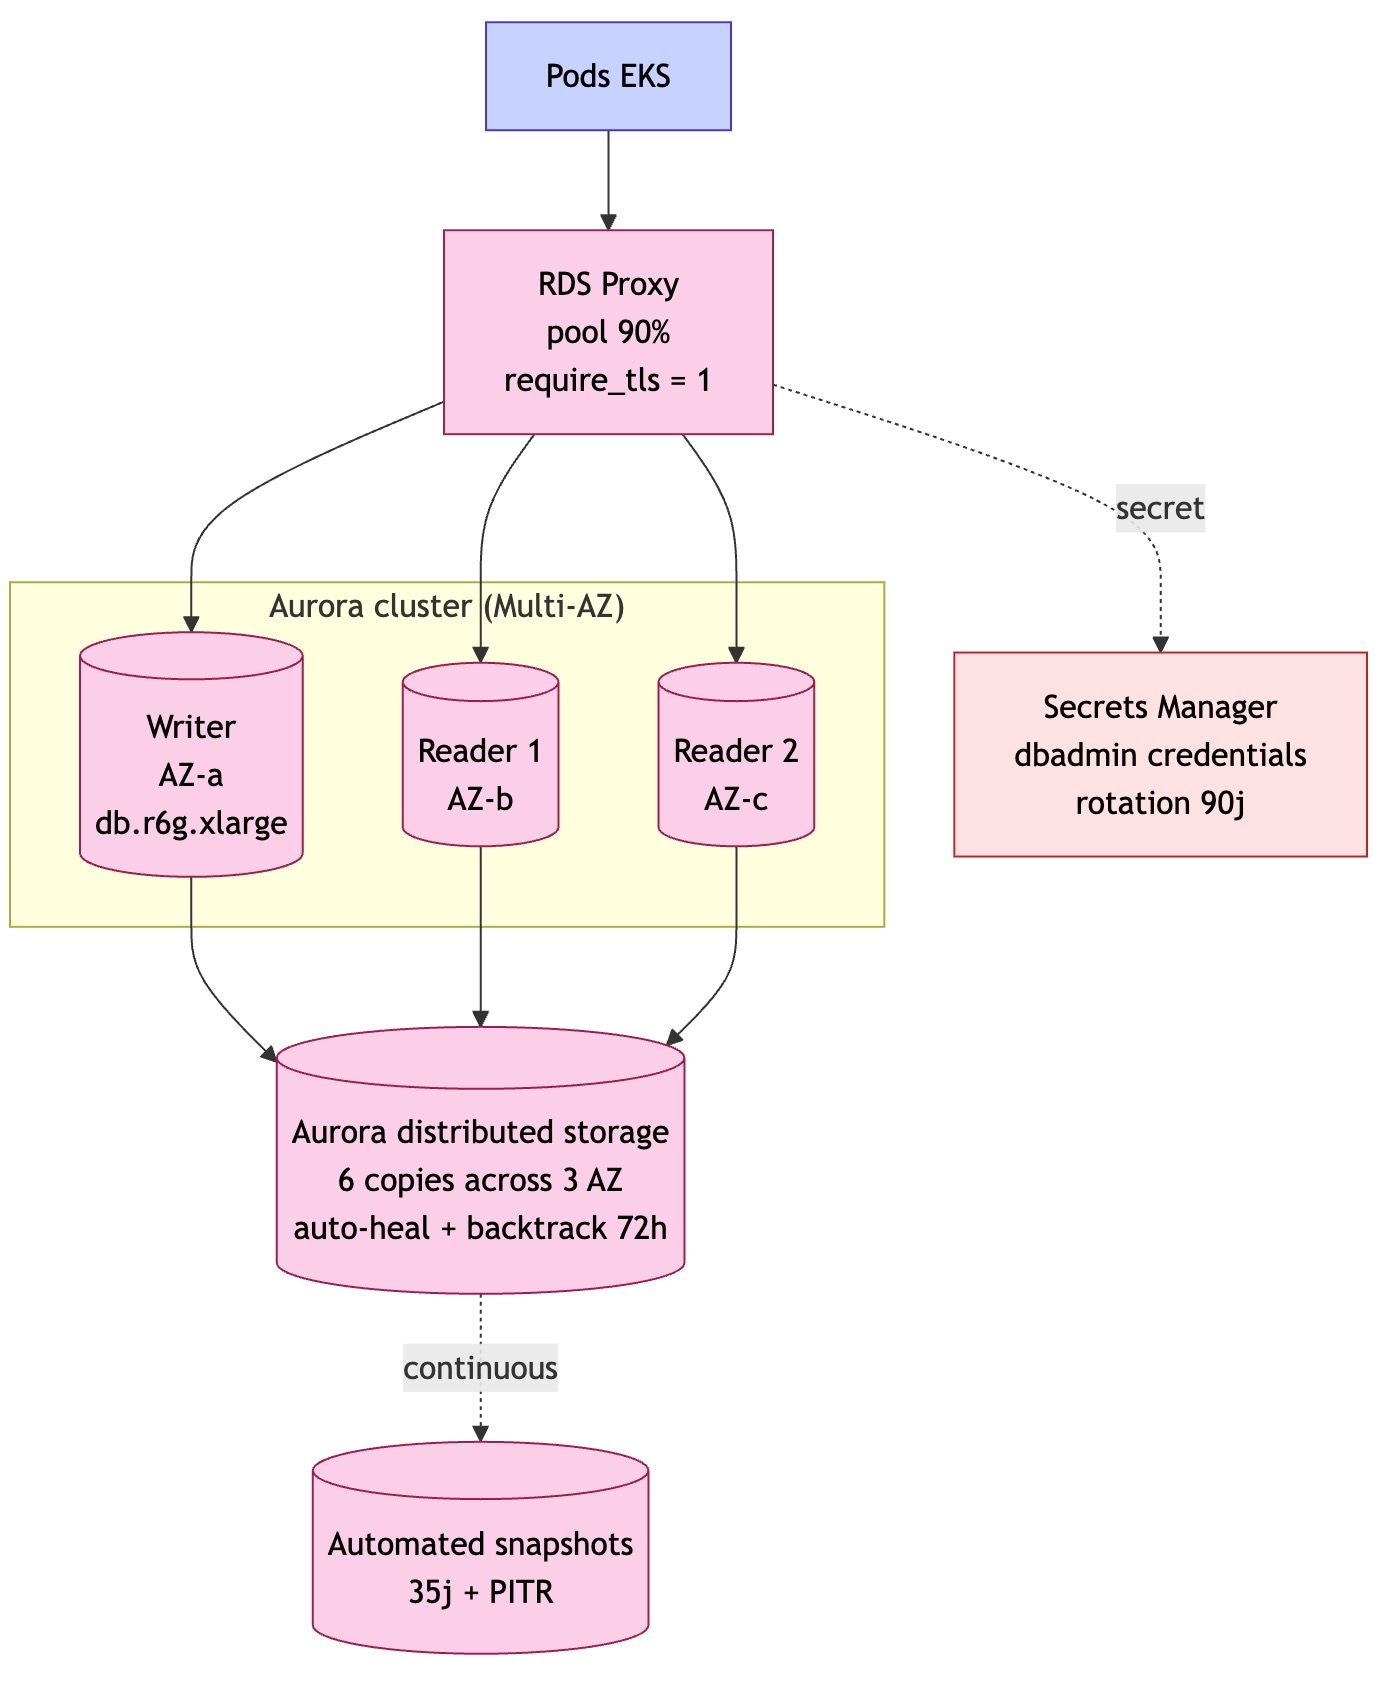
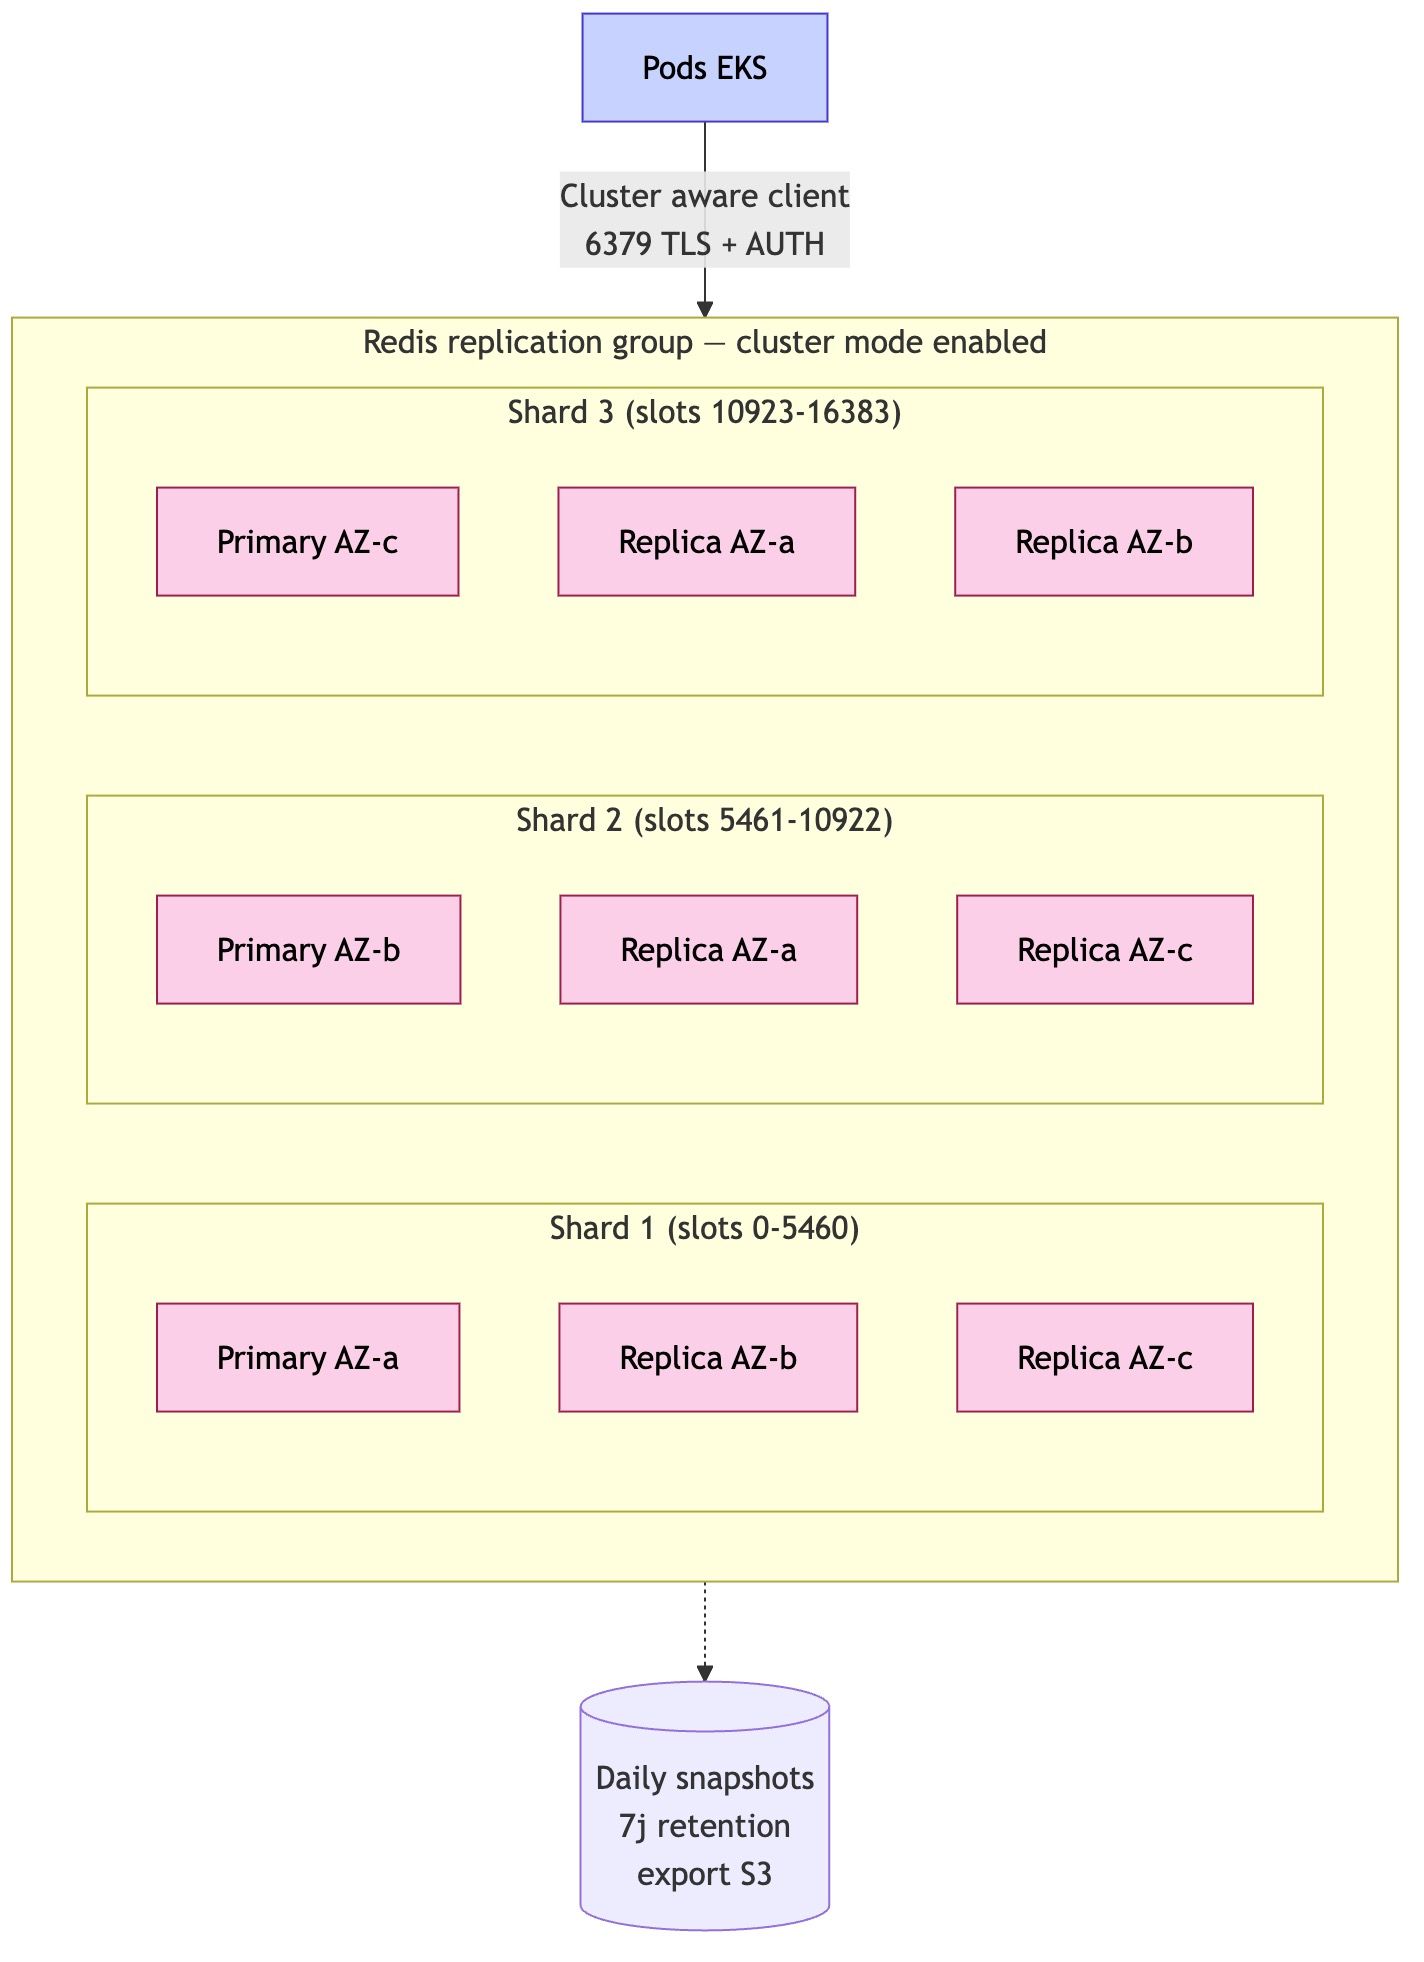
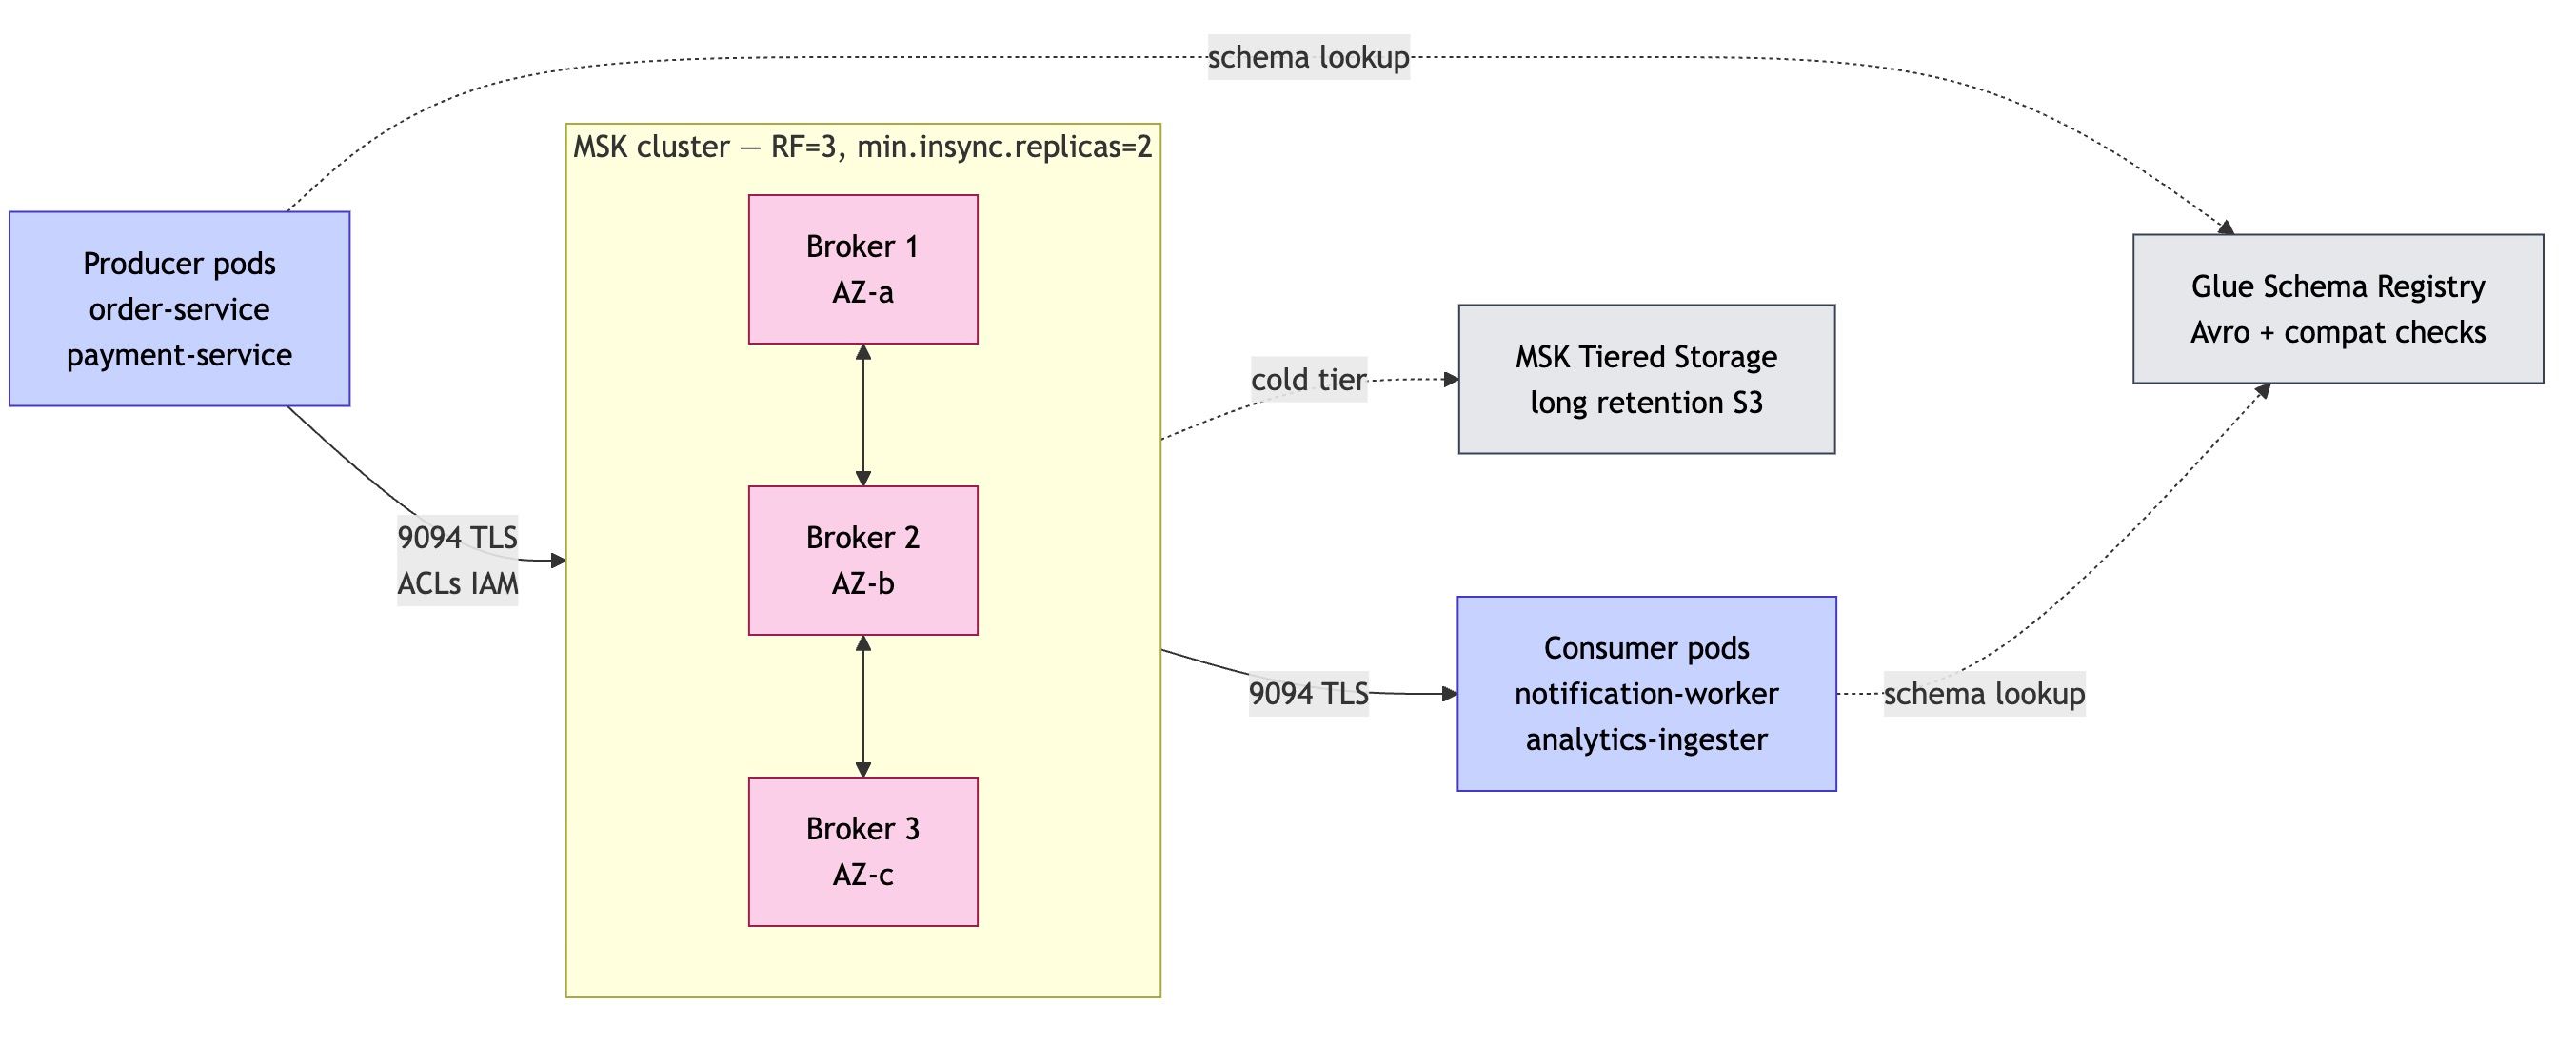
Concevoir une architecture cloud réellement résiliente : ce que font (vraiment) les entreprises matures sur AWS

Concevoir une architecture cloud réellement résiliente : ce que font (vraiment) les entreprises matures sur AWS

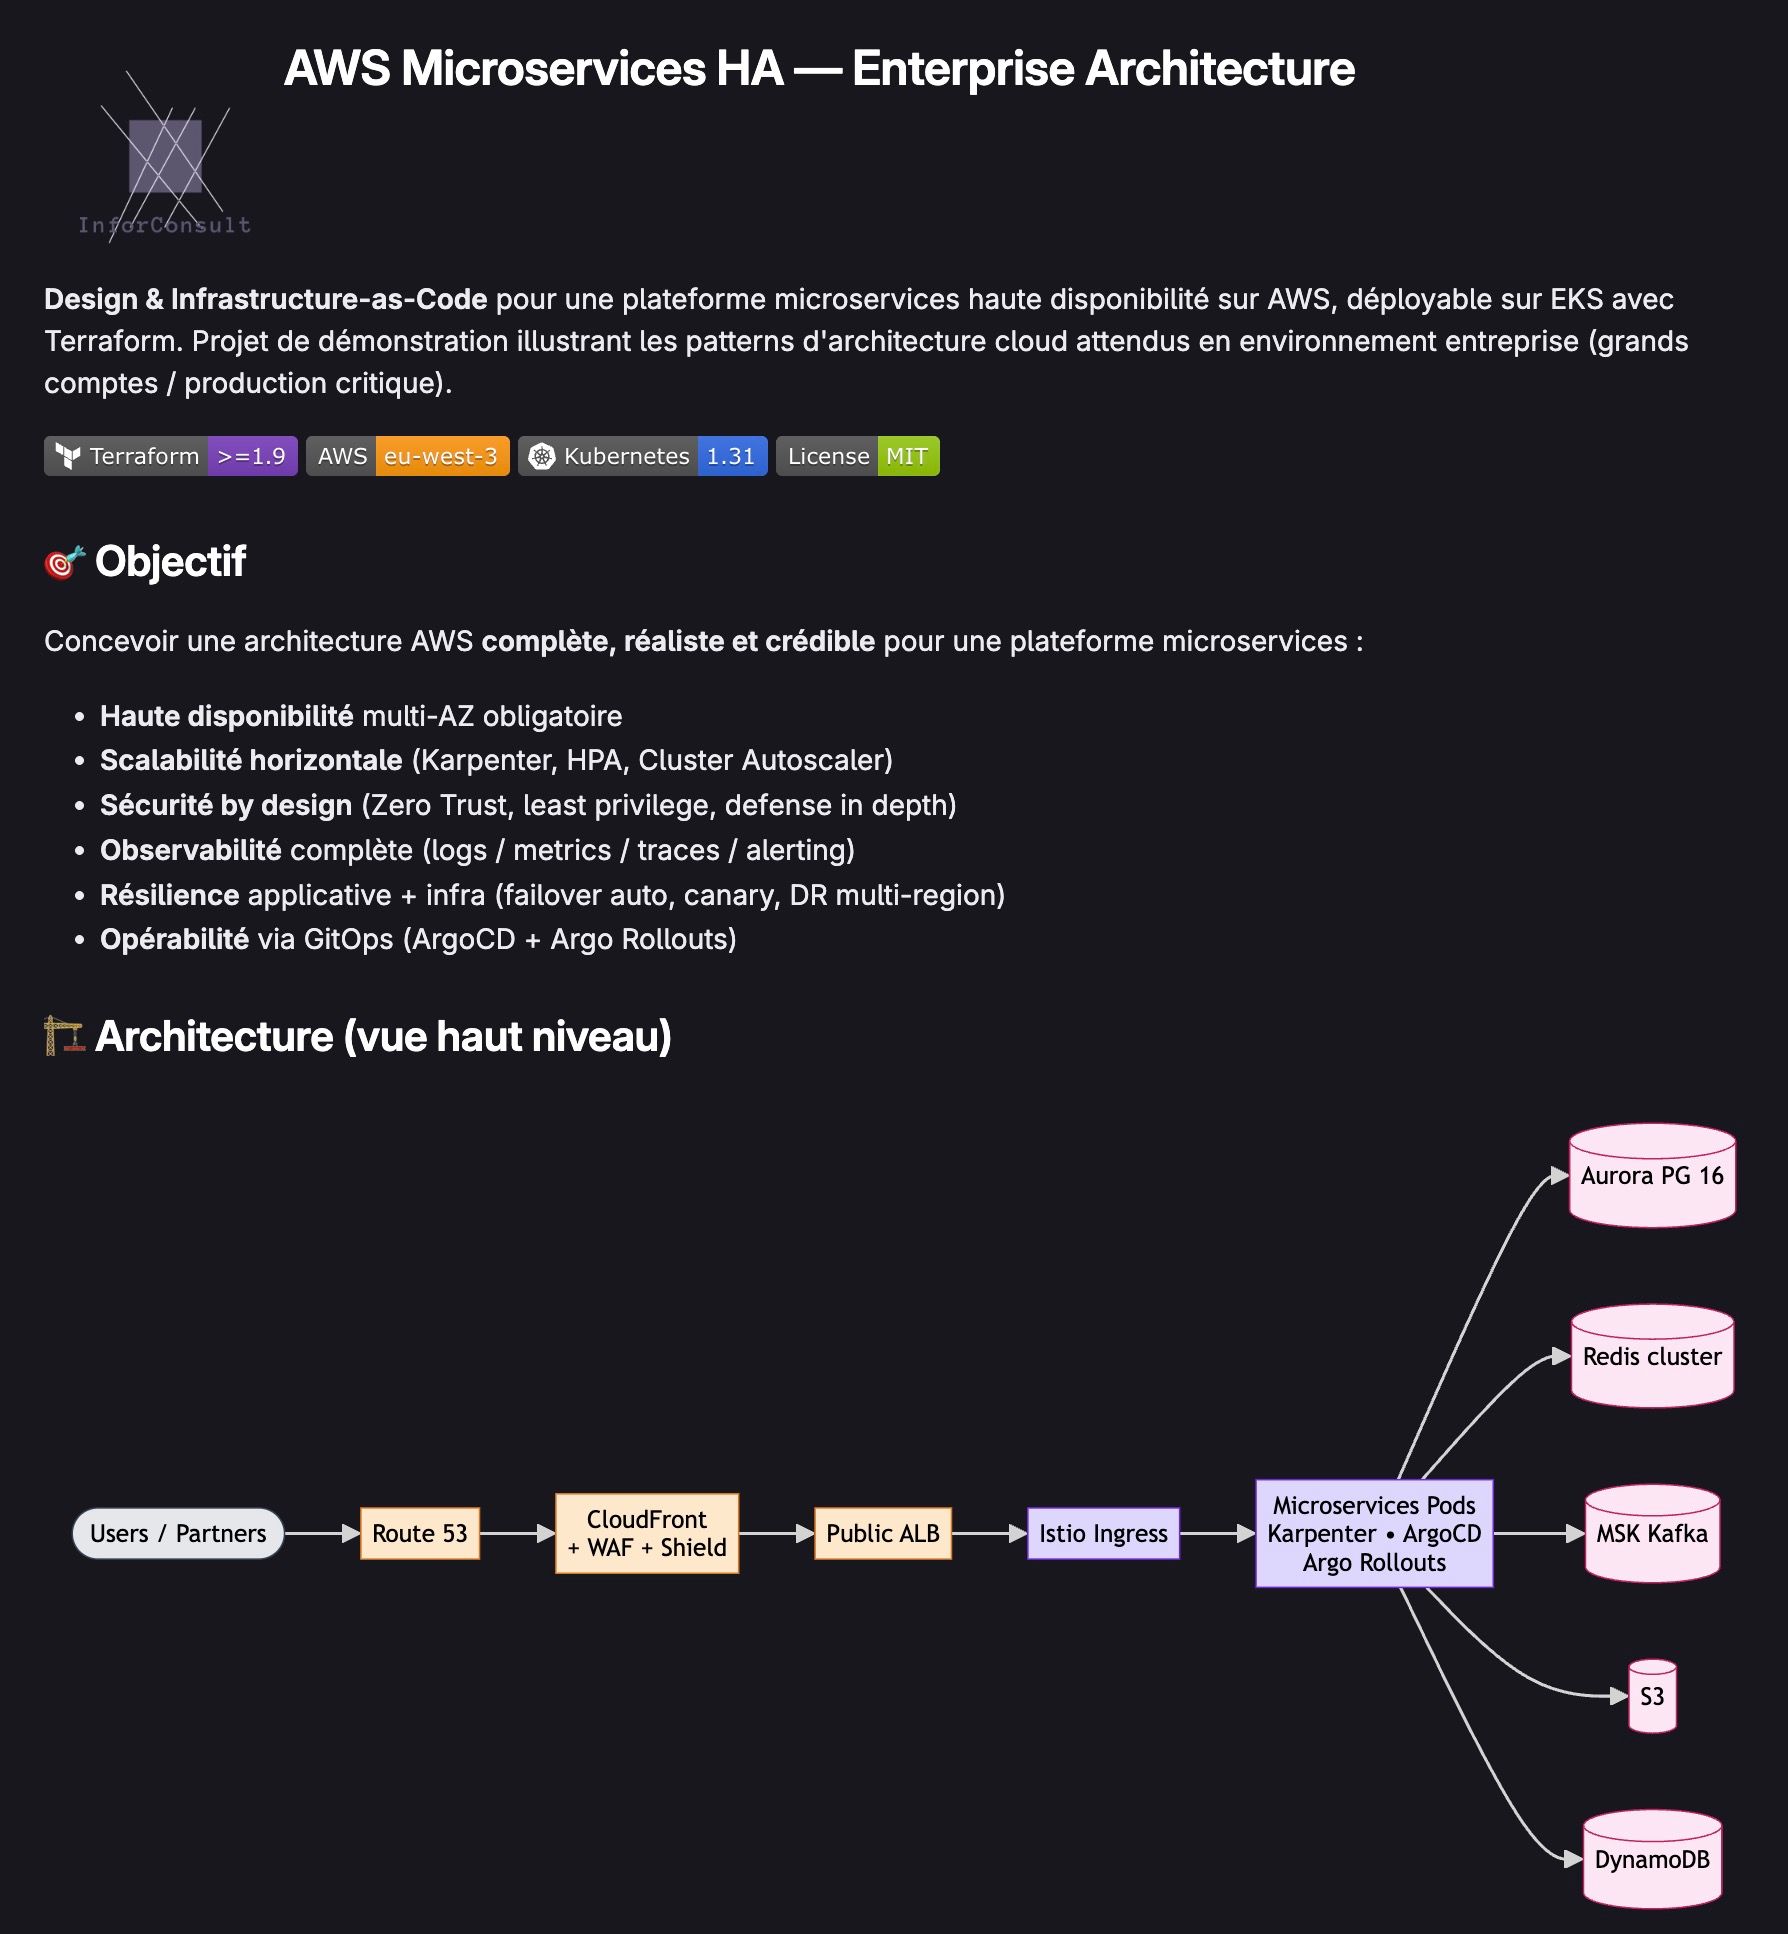
Aujourd’hui, beaucoup d’entreprises pensent être “cloud-ready”. En réalité, une grande partie des architectures que je vois reposent encore sur des compromis : dépendance à une seule zone sécurité approximative absence de stratégie de reprise après incident déploiements risqués 👉 Le problème n’est pas la technologie. 👉 Le problème, c’est le niveau d’exigence dans la conception. J’ai donc conçu une architecture AWS complète, inspirée des standards des grands comptes, pour répondre à une question simple : À quoi ressemble une plateforme microservices vraiment robuste, sécurisée et scalable en production ? Dans cet article, je vulgarise les grands principes sans jargon inutile. Maintenant passons à la partie technique détaillée :

🎯 Pourquoi ce projet ?

Dans les environnements critiques (SaaS, finance, industrie…), une architecture cloud ne doit pas seulement “fonctionner”.

Elle doit être capable de :

  • encaisser des pics de charge
  • résister à des pannes
  • sécuriser les données
  • évoluer sans interruption
  • être observable et pilotable

C’est exactement ce que j’ai modélisé ici : une architecture microservices haute disponibilité sur AWS, basée sur les bonnes pratiques des environnements entreprise.


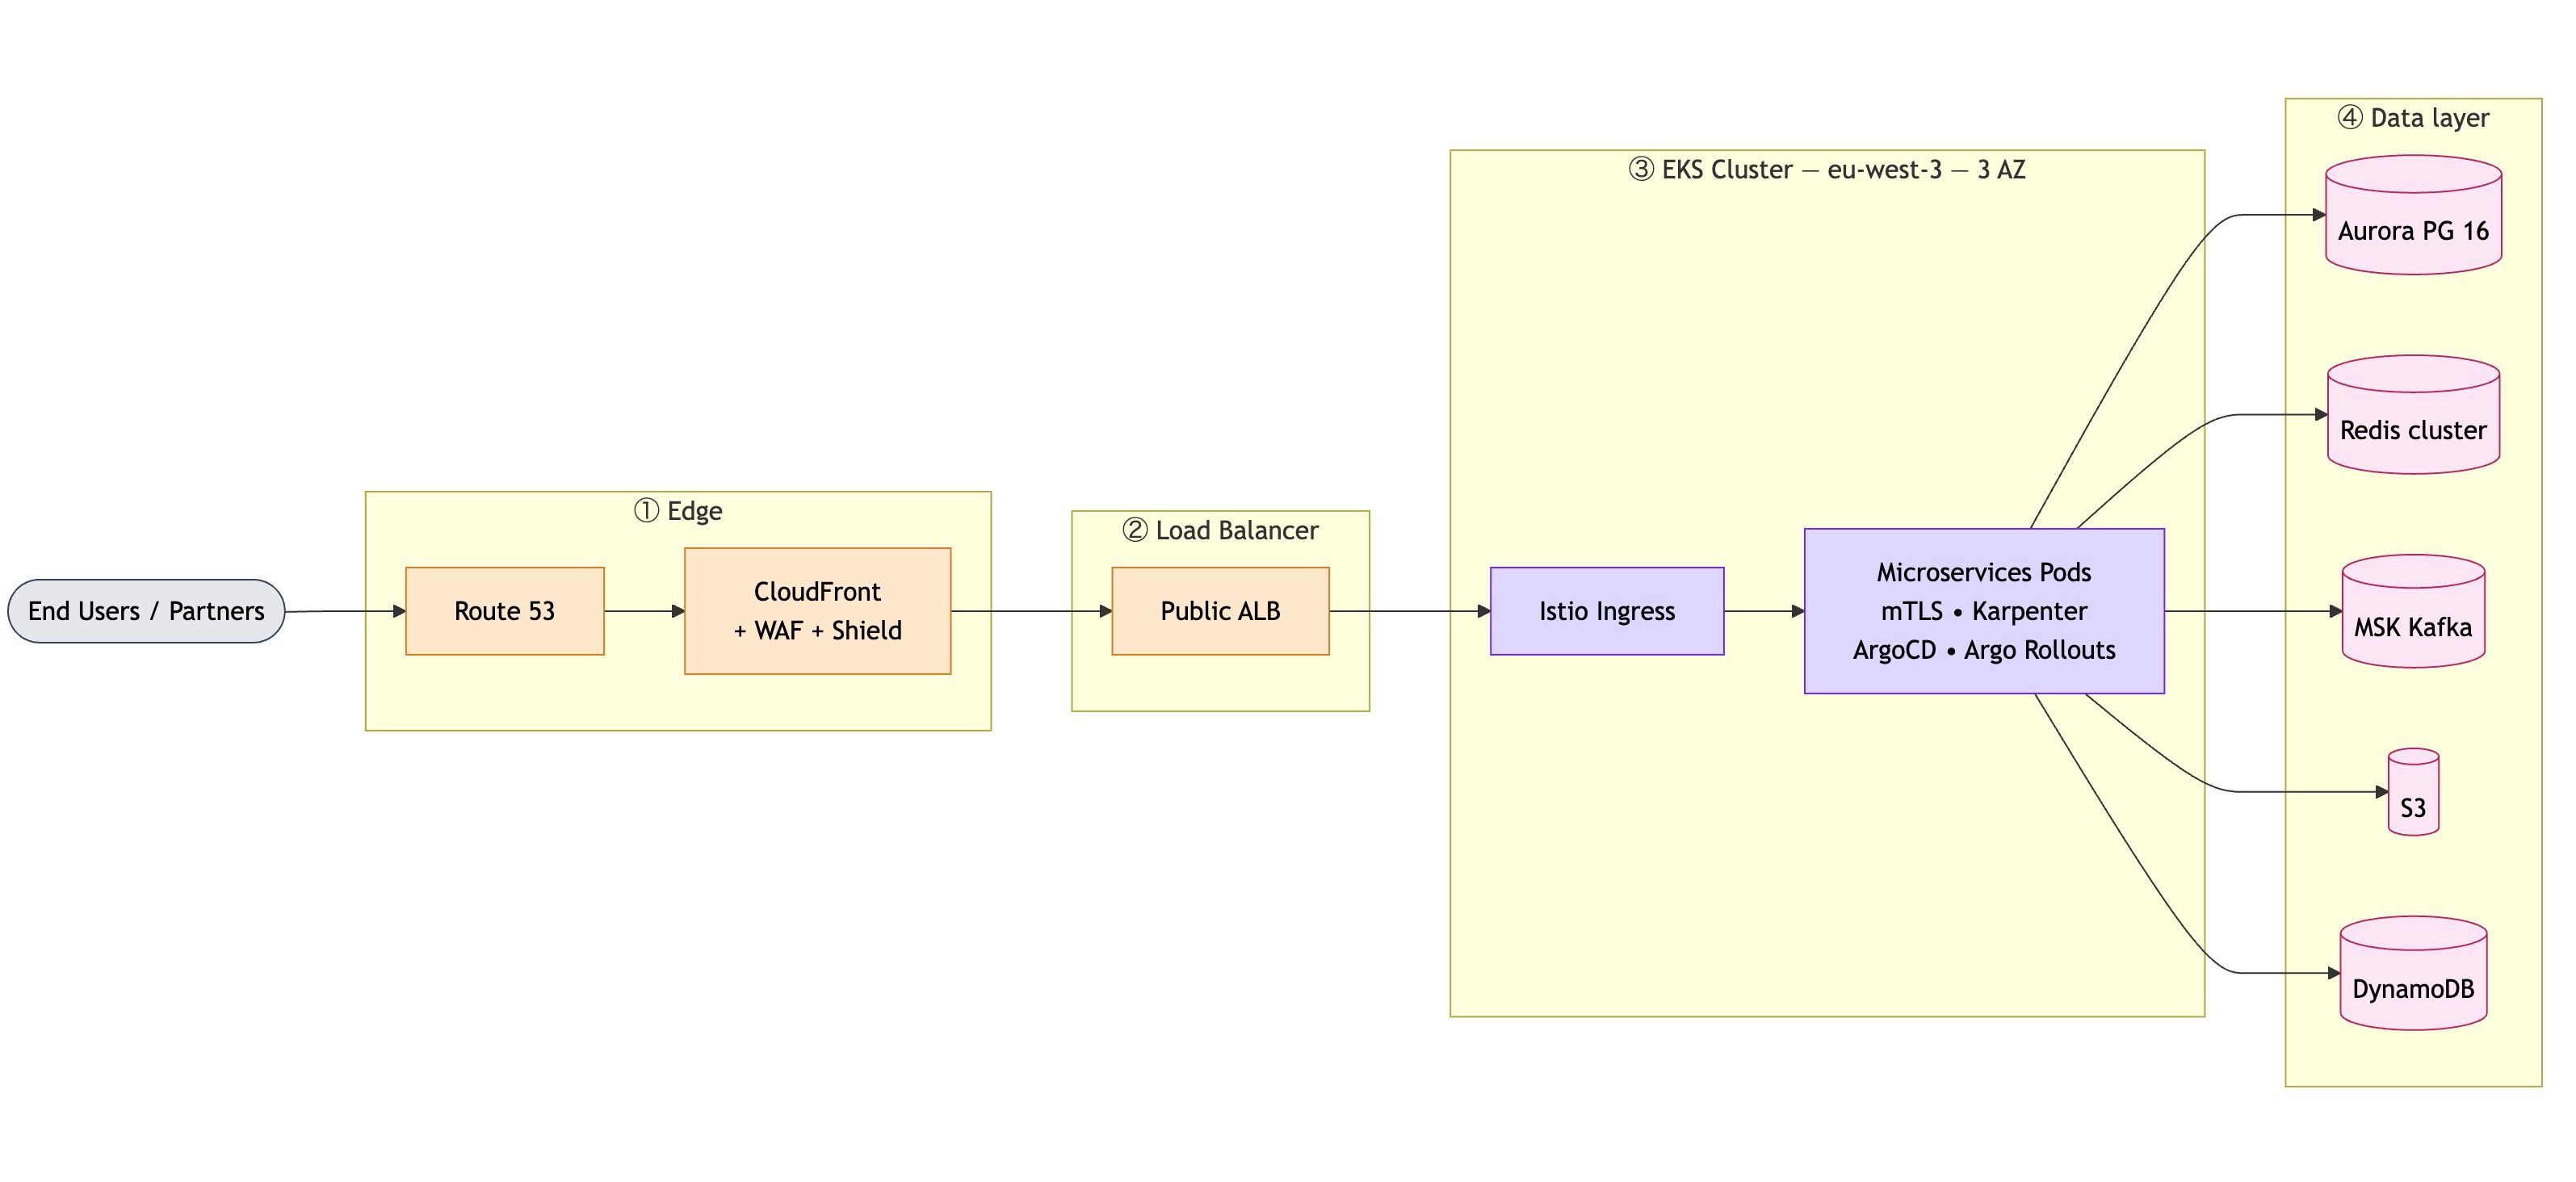
🏗️ 1. Une architecture pensée pour ne jamais tomber

Le principe global est simple :

  1. Les utilisateurs arrivent via Internet
  2. Le trafic passe par une couche de protection et de distribution
  3. Il est ensuite dirigé vers des services applicatifs (microservices)
  4. Les données sont stockées dans plusieurs systèmes spécialisés

👉 L’objectif : éviter tout point de défaillance unique

Concrètement :

  • plusieurs zones de disponibilité (data centers AWS)
  • duplication des services
  • bascule automatique en cas de problème

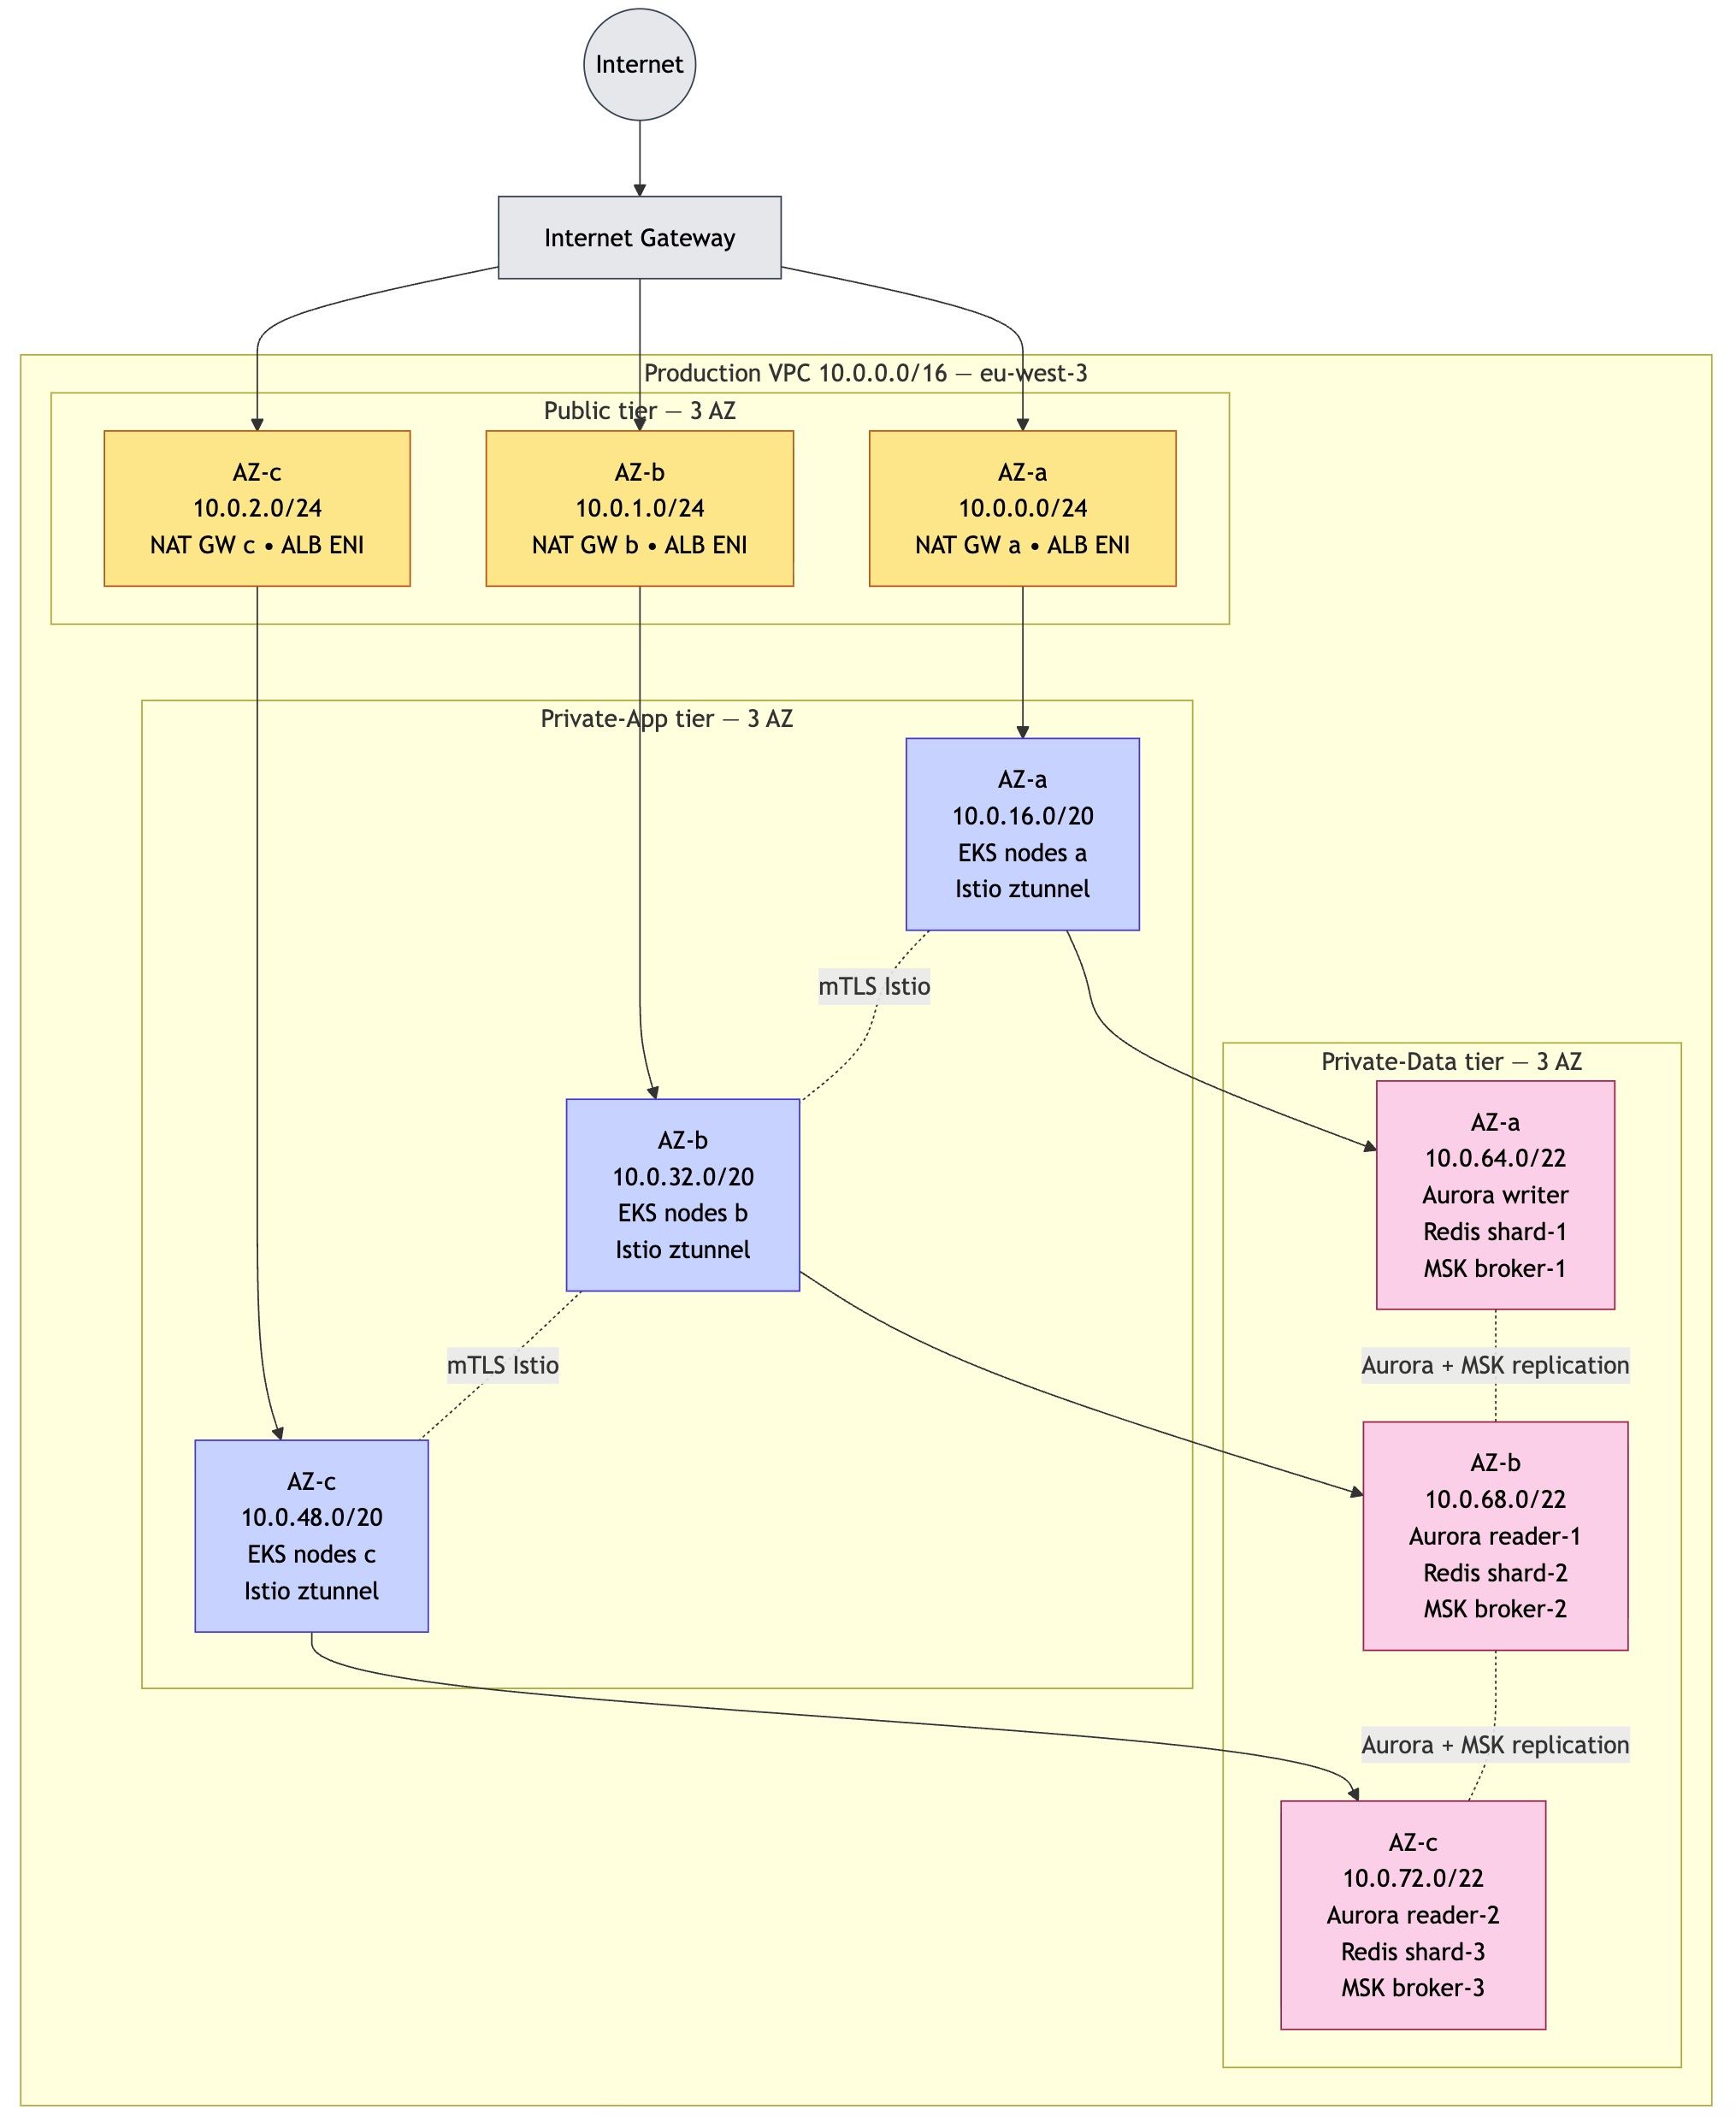
🌐 2. Un réseau conçu pour isoler et protéger

Le réseau est structuré en 3 niveaux :

  • Public → exposé à Internet (entrée du trafic)
  • Privé applicatif → les services métiers
  • Privé data → les bases de données (ultra isolées)

👉 Résultat :

  • les données sensibles ne sont jamais exposées
  • chaque couche a des règles de sécurité spécifiques

💾 3. Des données réparties selon leur usage

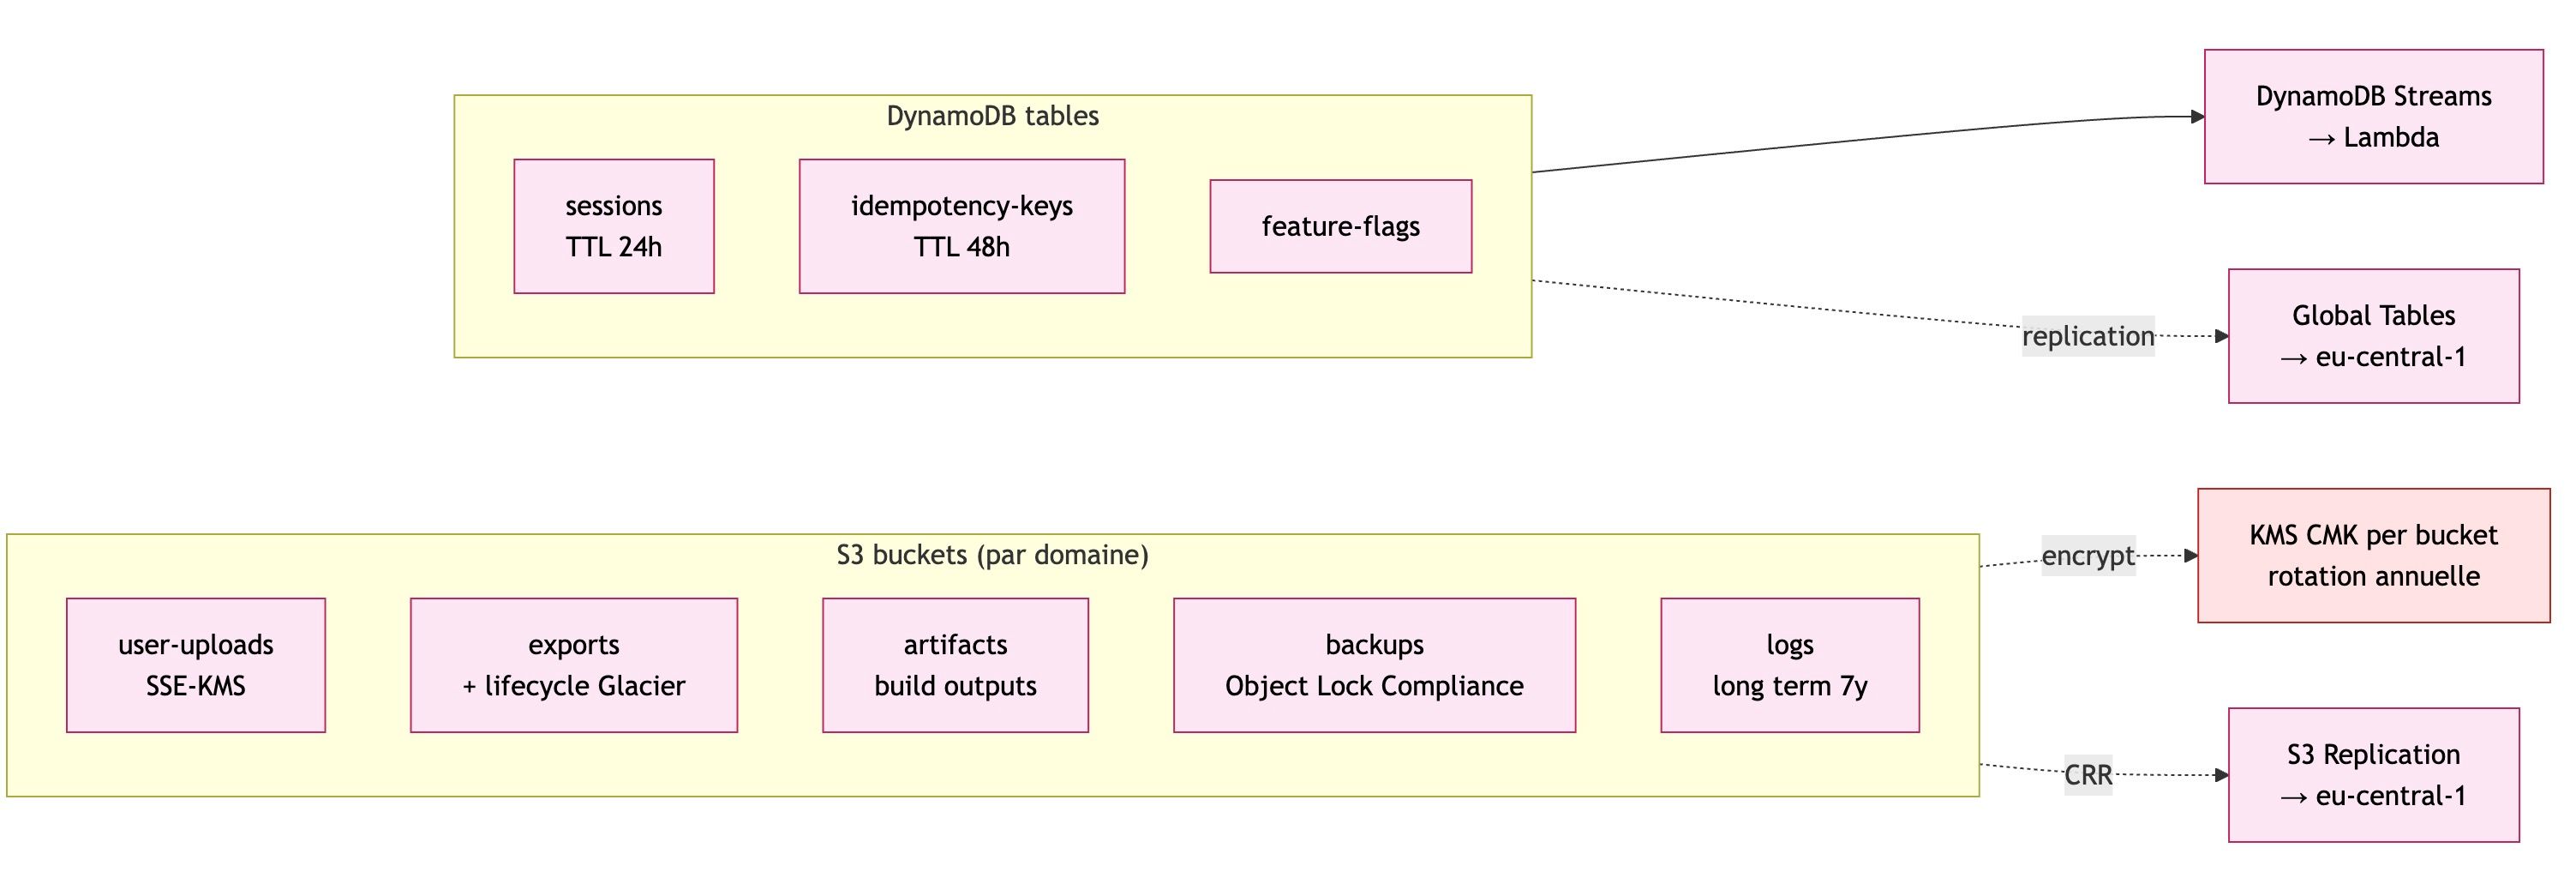
Toutes les données ne se ressemblent pas. Donc on utilise plusieurs technologies :

  • Base relationnelle → pour les transactions (ex : commandes)
  • Cache → pour la performance
  • Streaming → pour les événements en temps réel
  • Stockage objet → pour fichiers et sauvegardes
  • Base clé-valeur → pour la vitesse extrême

👉 Objectif : performance + résilience + scalabilité


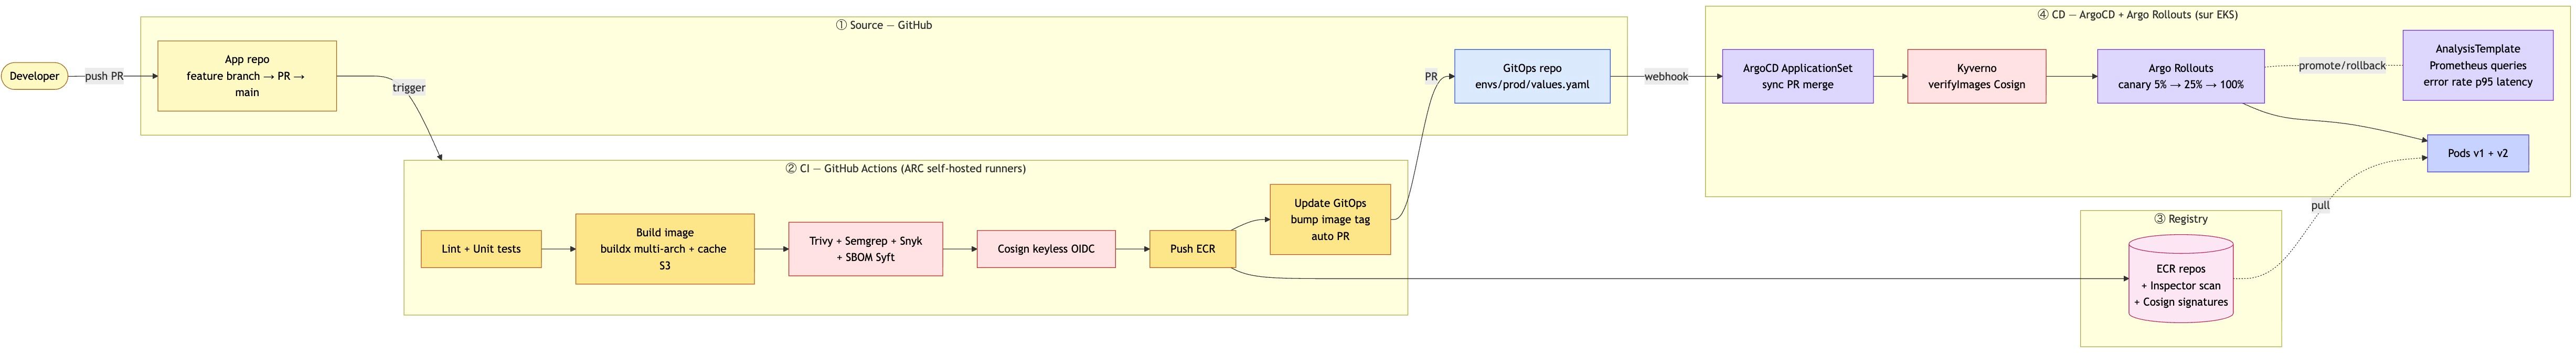
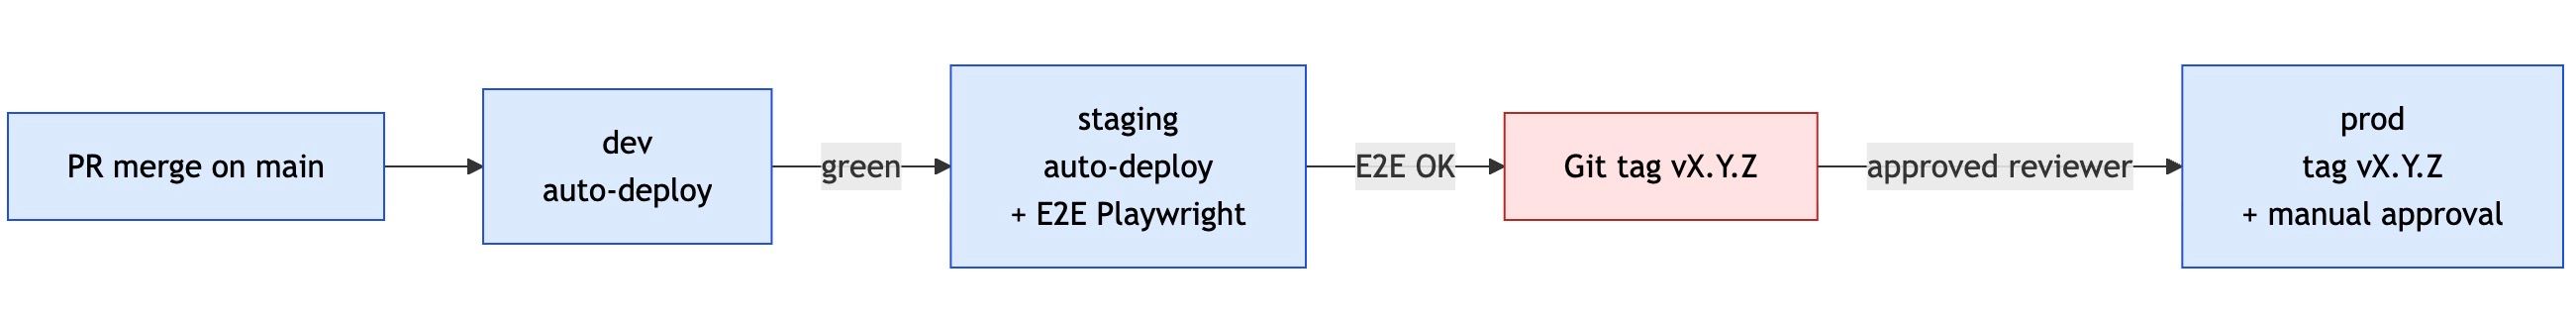
🚀 4. Des déploiements sans interruption (et sans stress)

Le déploiement suit un principe simple :

  1. Code testé automatiquement
  2. Analyse de sécurité
  3. Build et validation
  4. Déploiement progressif

👉 Exemple concret :

  • on déploie une nouvelle version sur 5% des utilisateurs
  • on observe le comportement
  • si tout va bien → on augmente progressivement

👉 Sinon → rollback automatique

Résultat :

  • moins de risques
  • plus de confiance
  • plus de vitesse

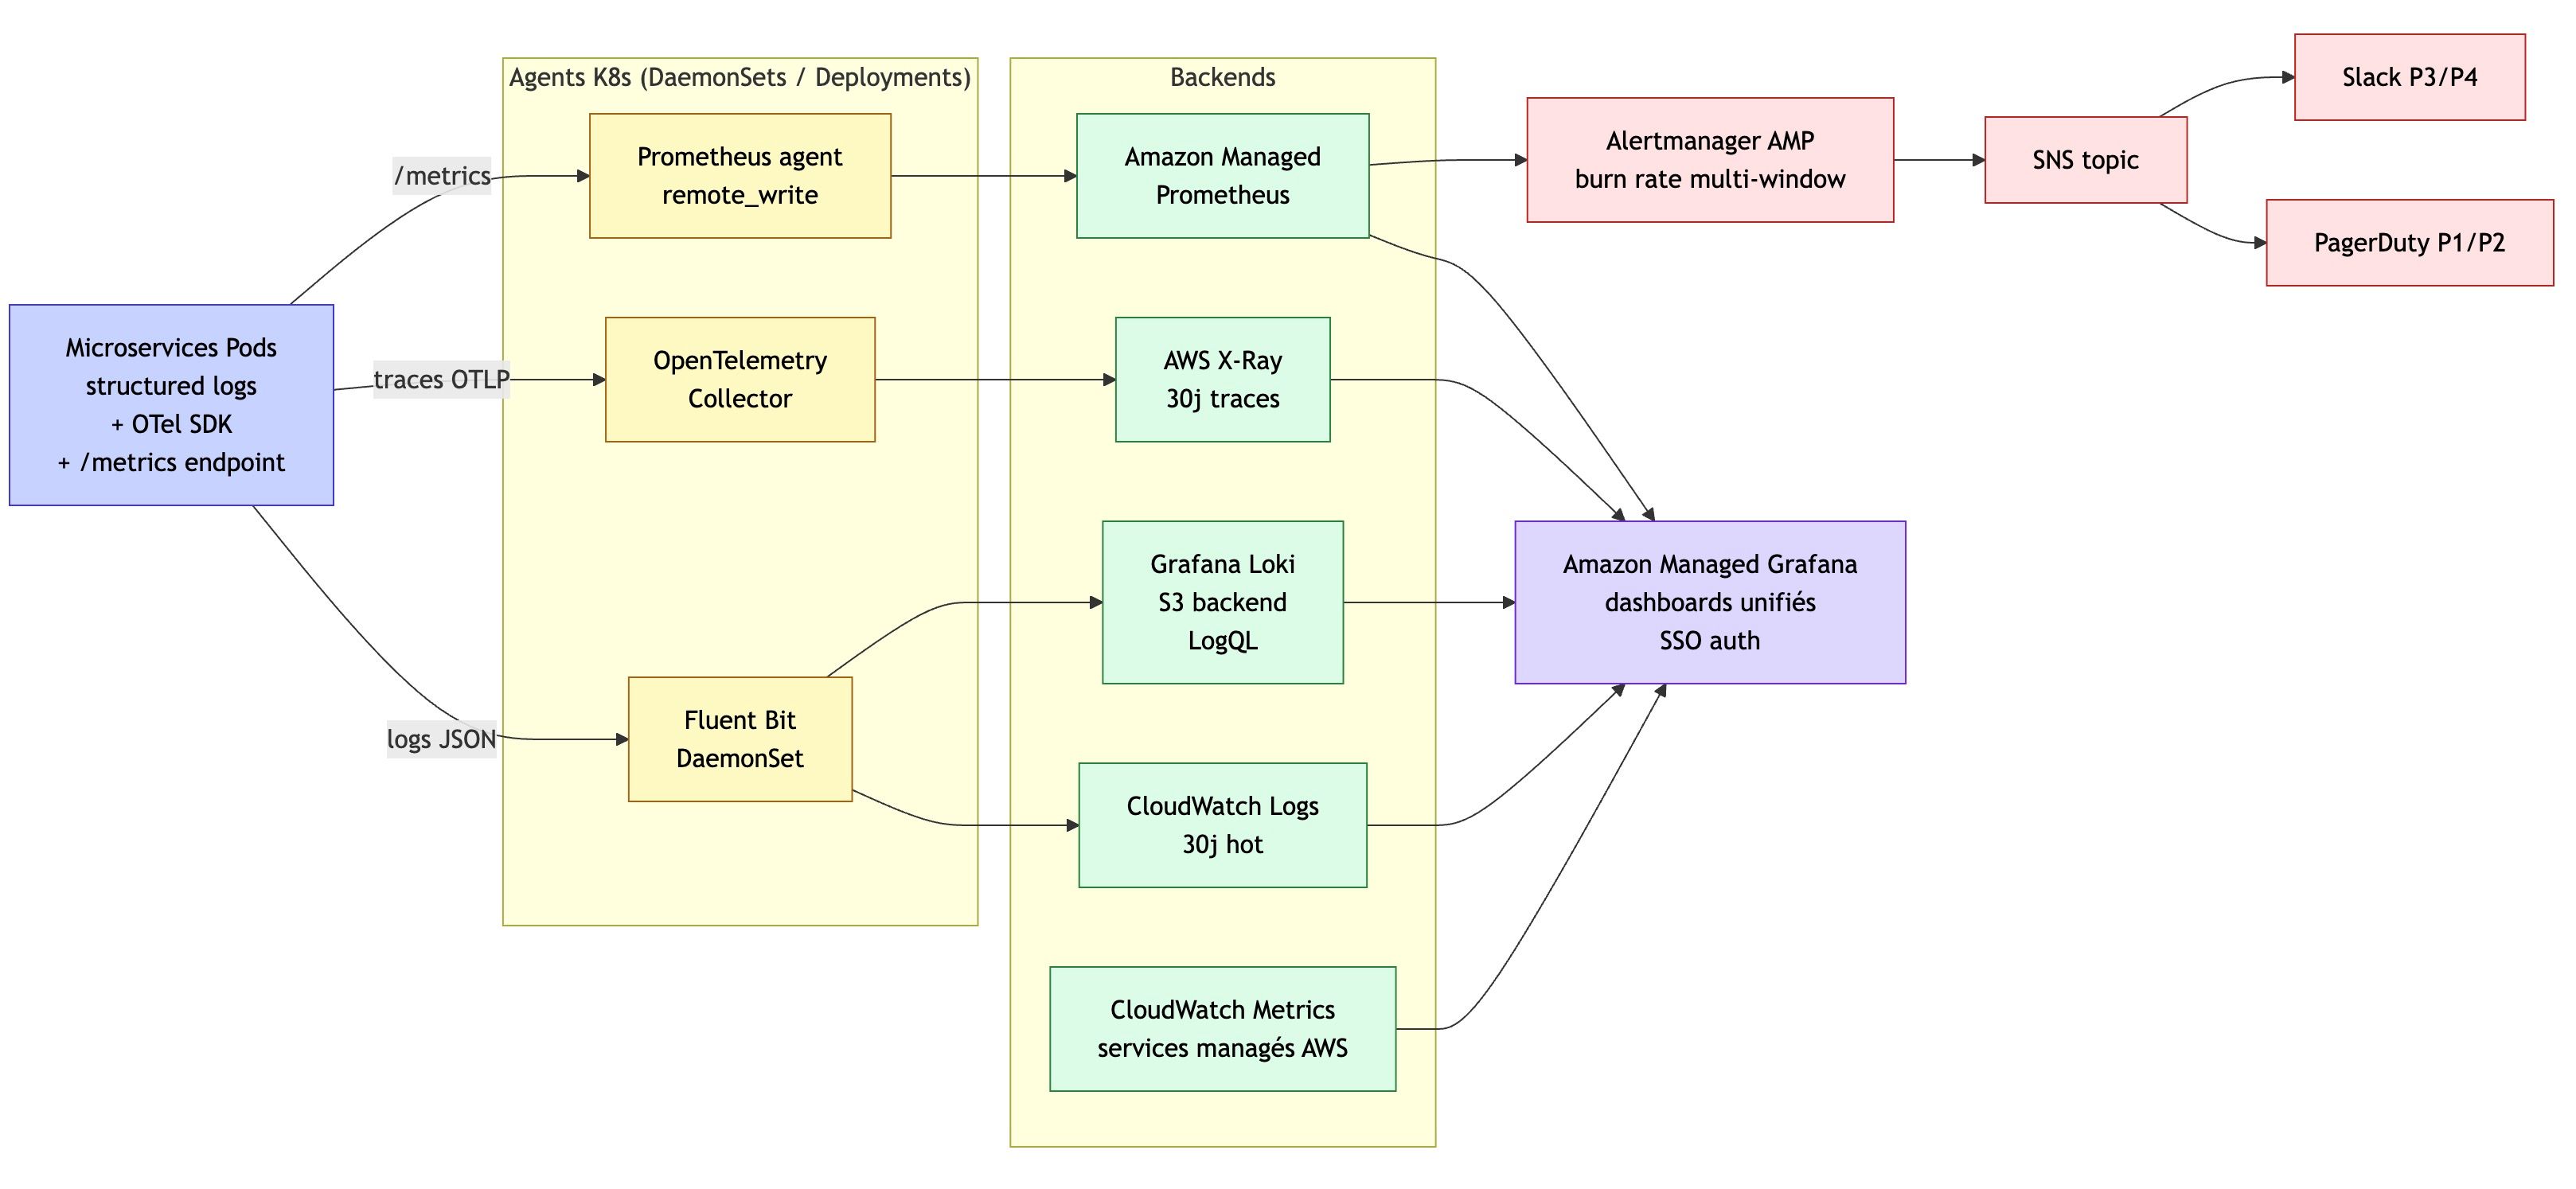
📊 5. Une visibilité complète (observabilité)

Une plateforme fiable, c’est une plateforme que l’on comprend.

On surveille donc :

  • les logs (ce qui s’est passé)
  • les métriques (CPU, erreurs, latence)
  • les traces (parcours complet d’une requête)

👉 Et surtout : on ne déclenche pas d’alertes “bêtes”

On utilise des SLO (objectifs de service) : → alerter uniquement quand l’expérience utilisateur est réellement impactée


🔐 6. Une sécurité pensée dès le départ

La sécurité repose sur plusieurs principes :

  • Zero Trust → rien n’est autorisé par défaut
  • Moindre privilège → chaque service a uniquement les droits nécessaires
  • Chiffrement partout
  • Aucune exposition inutile (pas de SSH, pas de bastion)

👉 Exemple : les accès humains passent par des systèmes sécurisés et audités → pas de “porte dérobée”


🔄 7. Et si toute la région tombe ?

C’est LA question que peu d’entreprises se posent vraiment.

Dans cette architecture :

  • les données sont répliquées dans une autre région AWS
  • une infrastructure minimale est déjà prête ailleurs
  • un basculement peut être déclenché

👉 Objectif :

  • perte de données quasi nulle
  • reprise en ~30 minutes

🧭 Ce qu’il faut retenir

Une architecture cloud moderne, ce n’est pas juste : 👉 “mettre des serveurs dans le cloud”

C’est un ensemble cohérent de choix :

  • disponibilité
  • sécurité
  • performance
  • automatisation
  • résilience

Et surtout : 👉 tout doit être pensé dès le départ


💡 Pourquoi ça intéresse les dirigeants ?

Parce que derrière la technique, il y a des enjeux business :

  • éviter les interruptions de service
  • protéger les données
  • accélérer le time-to-market
  • réduire les risques (cyber, opérationnels)
  • garantir la continuité d’activité

🔚 Conclusion

Beaucoup d’entreprises pensent être protégées…

…jusqu’au jour où ça casse.

👉 Une architecture robuste ne s’improvise pas.

C’est exactement le type de réflexion que je mène dans mes missions : concevoir des systèmes fiables, testés, et réellement adaptés aux contraintes métier.


Si ces sujets vous parlent (architecture cloud, résilience, automatisation, IA appliquée aux opérations), je serais curieux d’échanger.

iadevopsvirtualisationbackupcloud

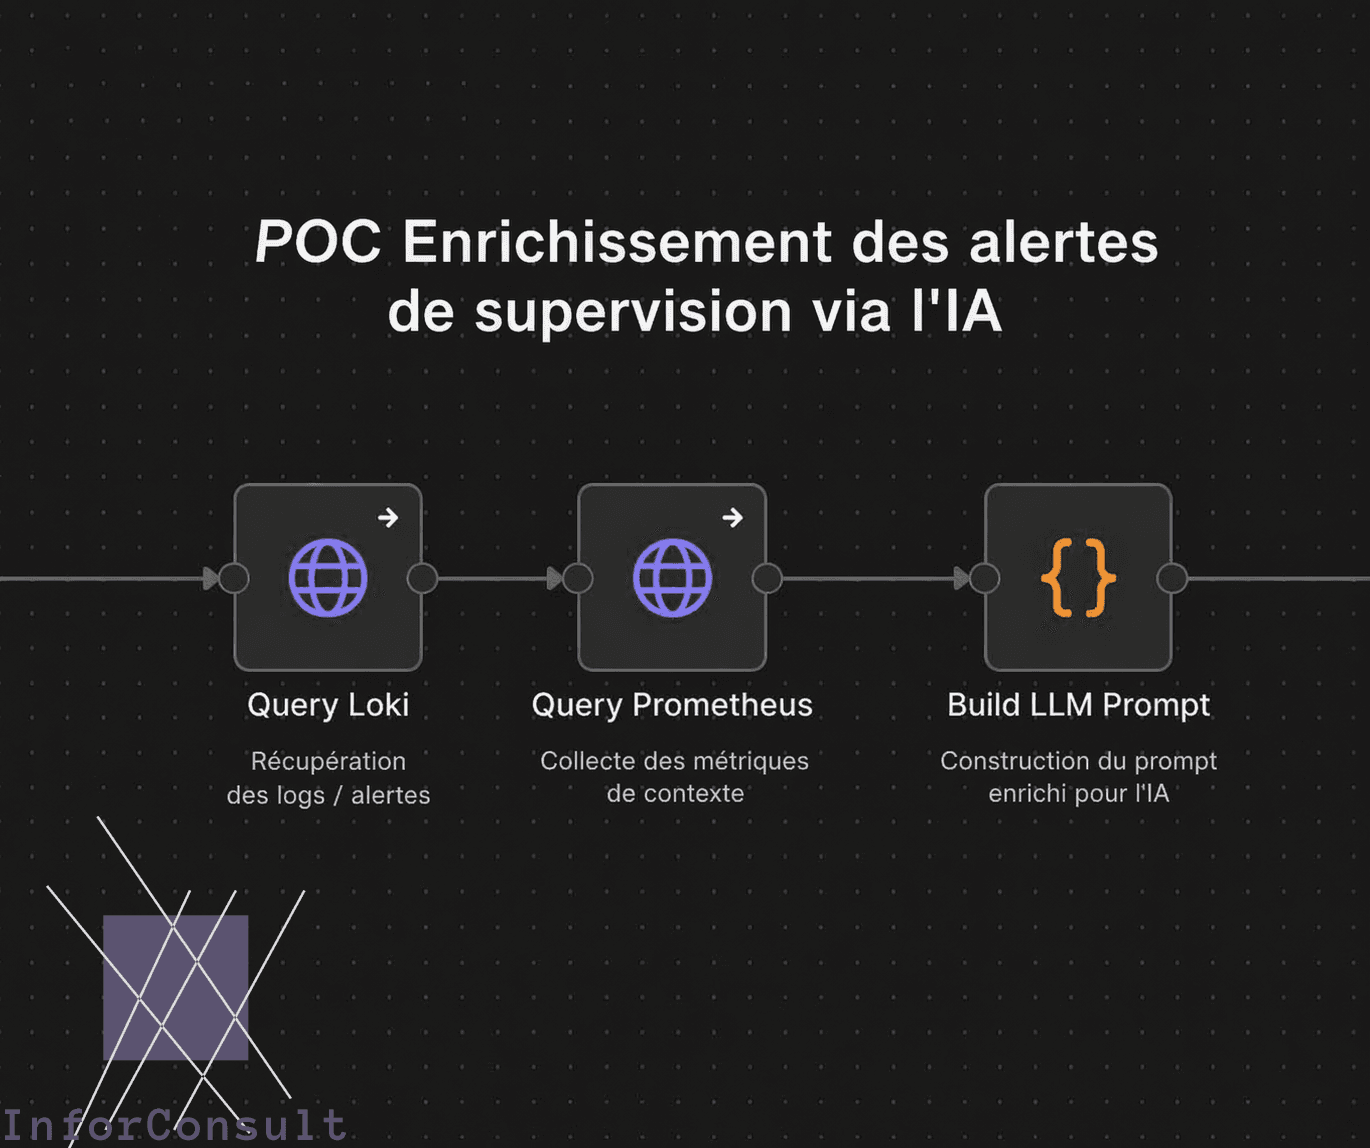
POC Enrichissement des alertes de supervision — De l'alerte brute au diagnostic augmenté par IA

POC Enrichissement des alertes de supervision — De l'alerte brute au diagnostic augmenté par IA

🔧 Dans ce POC, j'ai choisi d'améliorer la gestion des alertes issues de mon infrastructure, actuellement supervisée via Grafana, Prometheus, Loki et Alertmanager pour la gestion des notifications email. ⚠️ Plusieurs limites sont rapidement apparues, tant sur le fond que sur la forme. En particulier, le format des emails était peu exploitable, et les informations transmises manquaient de clarté et de hiérarchisation. Un point problématique notable concernait la distinction entre une alerte active et une alerte résolue : dans les deux cas, l'email reçu était strictement identique, avec un titre "ALERTE" dans les deux cas, et avec un attribut "resolved" présent dans les détails, peu visible et facilement manqué. 📧 Dans un premier temps, j'ai donc retravaillé la présentation des notifications. Pour cela, j'ai modifié la configuration d'Alertmanager afin d'envoyer les événements vers un webhook, reçu ensuite dans un workflow n8n pour reformatage. Ce premier niveau d'amélioration a perm…

Architecture technique du POC

  • Prometheus (LAN) : collecte les métriques système via node_exporter sur l'ensemble du parc (CPU, RAM, disque, réseau, SMART).
  • Grafana (LAN) : visualisation, dashboards et gestion des alertes.
  • Loki (LAN) : agrégation centralisée des logs via Promtail, indexés par labels (instance, job, level, log_type, service_name, filename).
  • Alertmanager (LAN) : réception des alertes Prometheus, déduplication, routage vers le webhook n8n.
  • Ollama (LAN) : serveur LLM auto-hébergé exécutant un modèle léger, dédié à l'analyse des alertes.
  • n8n (DMZ) : orchestration du workflow d'enrichissement, appel au LLM et envoi des emails.

18 règles d'alerte Prometheus sont définies, organisées en fichiers thématiques couvrant les métriques système (CPU, mémoire, disque, filesystem), les services applicatifs, les sondes blackbox, le réseau et la santé SMART des disques. Ce sont les règles du groupe node (CPUHigh, MemHigh, FSDanger, FilesystemReadOnly) qui bénéficient directement de l'enrichissement dans ce POC.

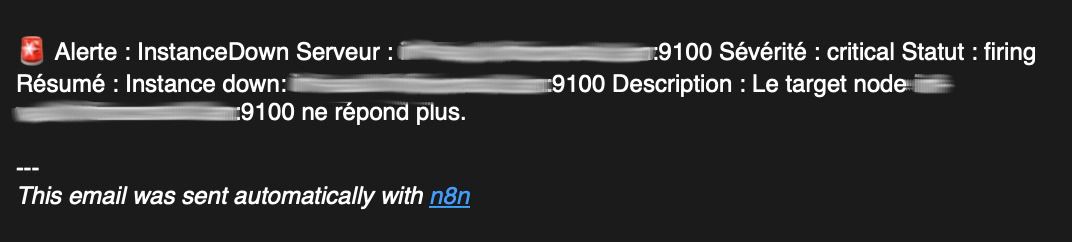
Test 1 : Arrêt manuel d'un node.

Email d'alerte avant retraitement : Email de résolution avant retraitement :
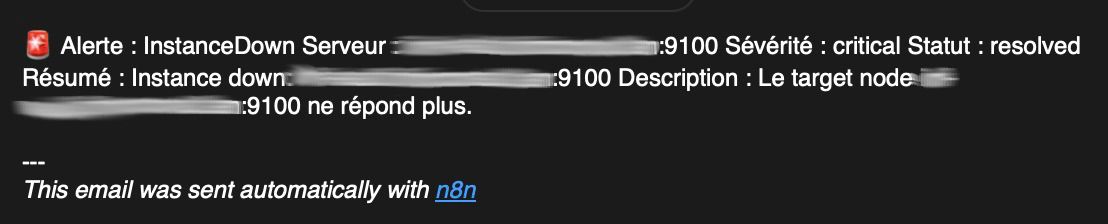
Pas très clair...

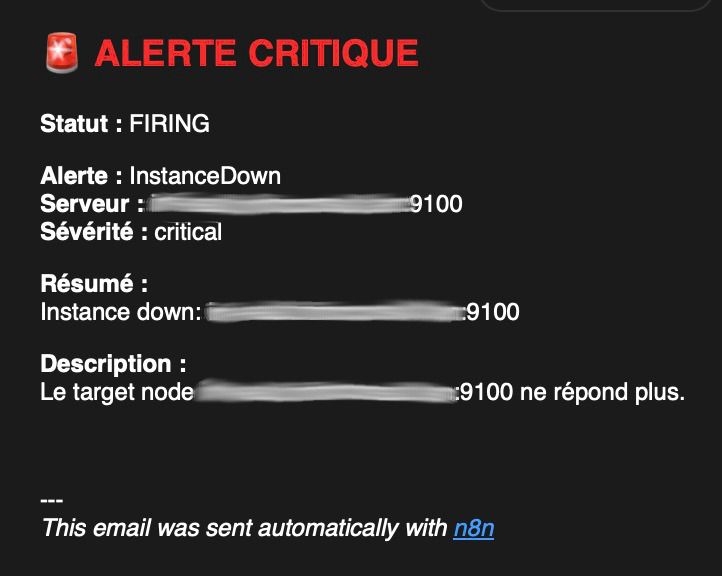
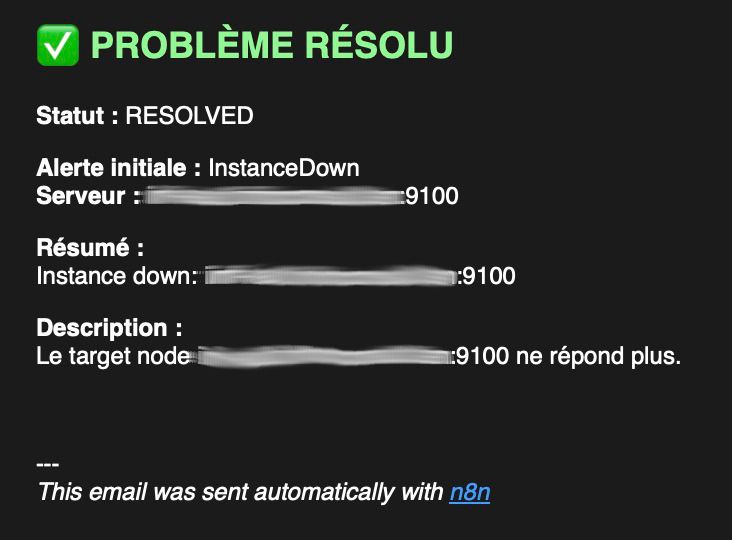
Un workflow n8n initial a donc été mis en place pour intercepter les événements via webhook et reconstruire entièrement l'email. Le code JavaScript en entrée du workflow parse le payload Alertmanager, extrait les champs utiles (nom de l'alerte, instance, sévérité, durée du downtime) et les transmet à un nœud de mise en forme HTML. Ce dernier génère un email structuré avec un code couleur immédiatement lisible : rouge pour une alerte active, vert pour une résolution, avec un sujet d'email conditionnel permettant le tri en boîte de réception d'un simple coup d'œil. Ce premier palier, relativement simple à mettre en œuvre, a suffi à transformer l'expérience utilisateur côté notification.

Mail d'alerte

Mail de résolution

C'est sur cette base que s'appuient les étapes suivantes.

Workflow n8n : de l'alerte brute au diagnostic enrichi

Chaîne de traitement initiale

Le workflow recevait les alertes Alertmanager via webhook POST, extrayait les champs clés (alertname, instance, severity, status, durée), formatait un email HTML et l'envoyait. Fonctionnel, mais limité : aucun contexte, aucune aide au diagnostic.

Chaîne enrichie

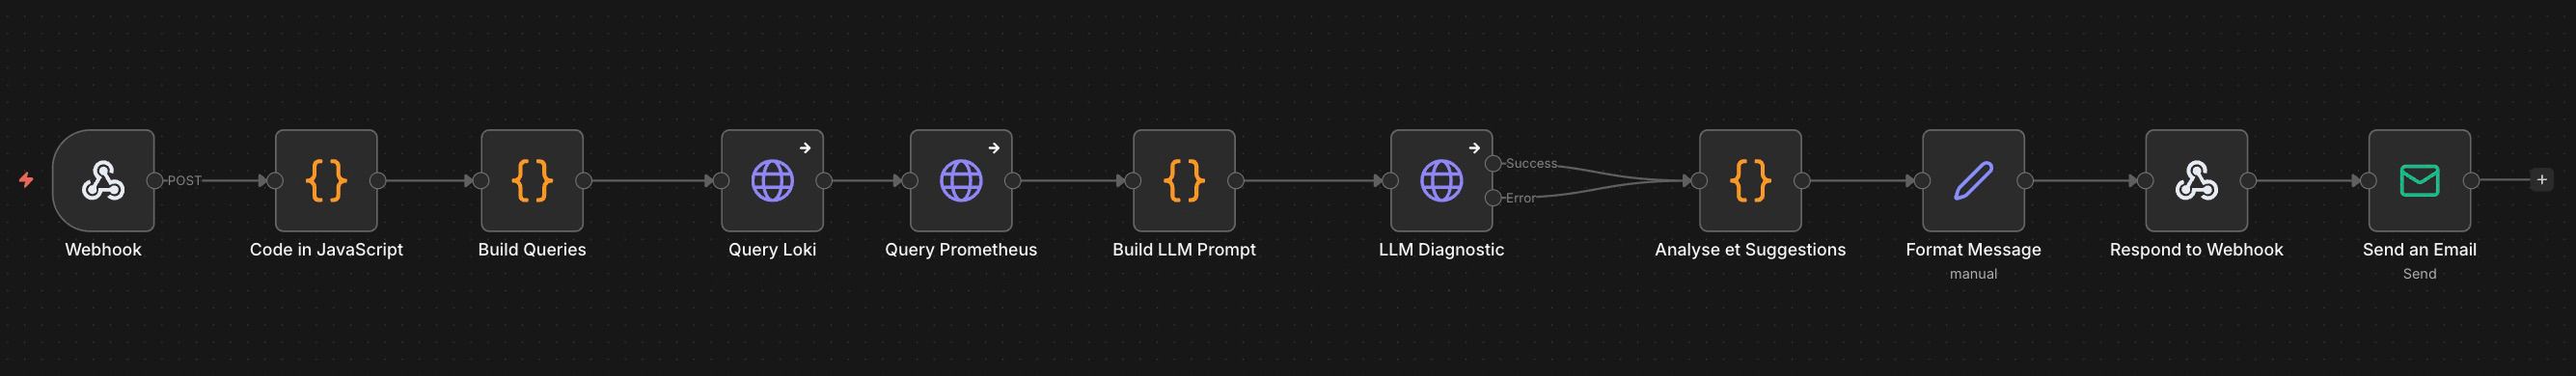
Cinq nœuds ont été insérés entre le parsing de l'alerte et la mise en forme de l'email :

  1. Build Queries (Code JavaScript) — Construit dynamiquement les requêtes Loki et Prometheus selon le type d'alerte. Par exemple, pour une alerte CPUHigh, la requête Prometheus calculera le pourcentage CPU réel via rate(node_cpu_seconds_total) ; pour FSDanger, elle cartographiera l'occupation de chaque point de montage. Un point d'attention a été la corrélation des labels entre Prometheus (FQDN avec port) et Loki (hostname court) : le nœud extrait automatiquement le hostname court pour interroger Loki.
  2. Query Loki (HTTP Request) — Interroge l'API Loki sur une fenêtre de 15 minutes en filtrant les logs de l'instance concernée avec un pattern regex ciblant les niveaux error, critical, warn, fail, panic, oom et killed. Le label instance sert de clé de corrélation entre l'alerte Prometheus et les logs Loki.
  3. Query Prometheus (HTTP Request) — Récupère la valeur en temps réel de la métrique en alerte. Le technicien voit immédiatement si le problème est toujours actif au moment de la lecture de l'email.
  4. Build LLM Prompt (Code JavaScript) — Prépare le contexte pour le LLM : type d'alerte, instance concernée, sévérité et valeur actuelle de la métrique. Le prompt est volontairement concis pour garantir un temps de réponse acceptable. Ce nœud isole la construction de la requête de l'appel HTTP, ce qui s'est avéré nécessaire pour contourner les limitations du parser d'expressions n8n sur les payloads JSON complexes.
  5. LLM Diagnostic (HTTP Request) — Envoie le prompt au serveur Ollama et récupère la réponse. Le modèle retourne un diagnostic en langage naturel avec des actions correctives adaptées au type d'incident.
  6. Analyse et Suggestions (Code JavaScript) — Compile l'ensemble des données (Loki, Prometheus, LLM) et génère :
  • Un niveau de criticité calculé dynamiquement (pas seulement la severity de l'alerte, mais aussi le volume de logs d'erreur détectés).
  • La valeur temps réel de la métrique (ex : « 87.3% CPU »).
  • Des commandes de remédiation directement exécutables, adaptées au type d'incident, générées par règles déterministes (switch/case selon le type d'alerte). Par exemple, pour un disque plein : identification des répertoires volumineux, purge des anciens logs journald, nettoyage des paquets obsolètes.
  • Le diagnostic IA en langage naturel, présenté dans une section dédiée de l'email.

L'email final intègre désormais un tableau de synthèse, les dernières lignes de logs Loki pertinentes, une liste de commandes prêtes à l'emploi, et le diagnostic IA. La distinction visuelle entre alerte active et résolue est appliquée dès le sujet de l'email — les emails de résolution ne contiennent volontairement que le résumé, sans le bloc d'analyse complet.

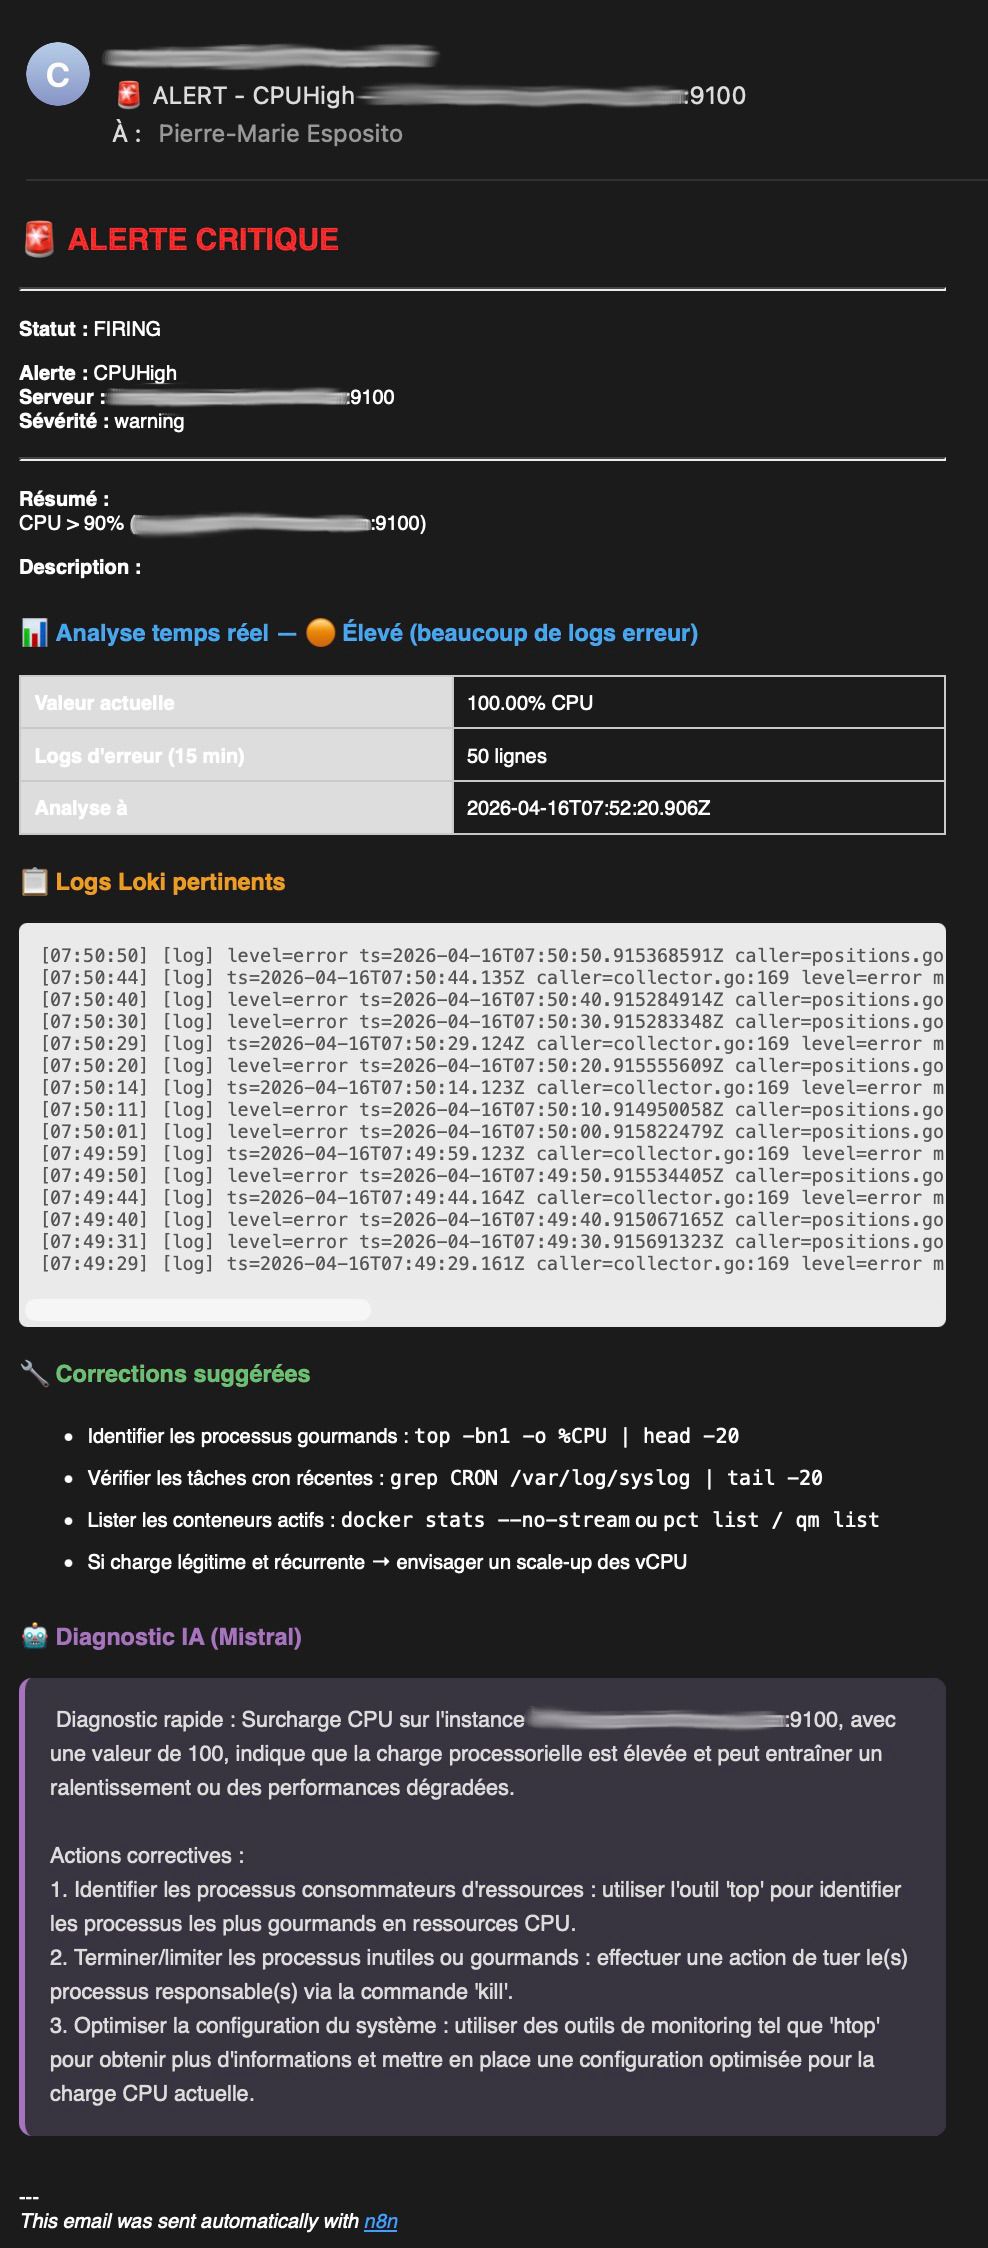
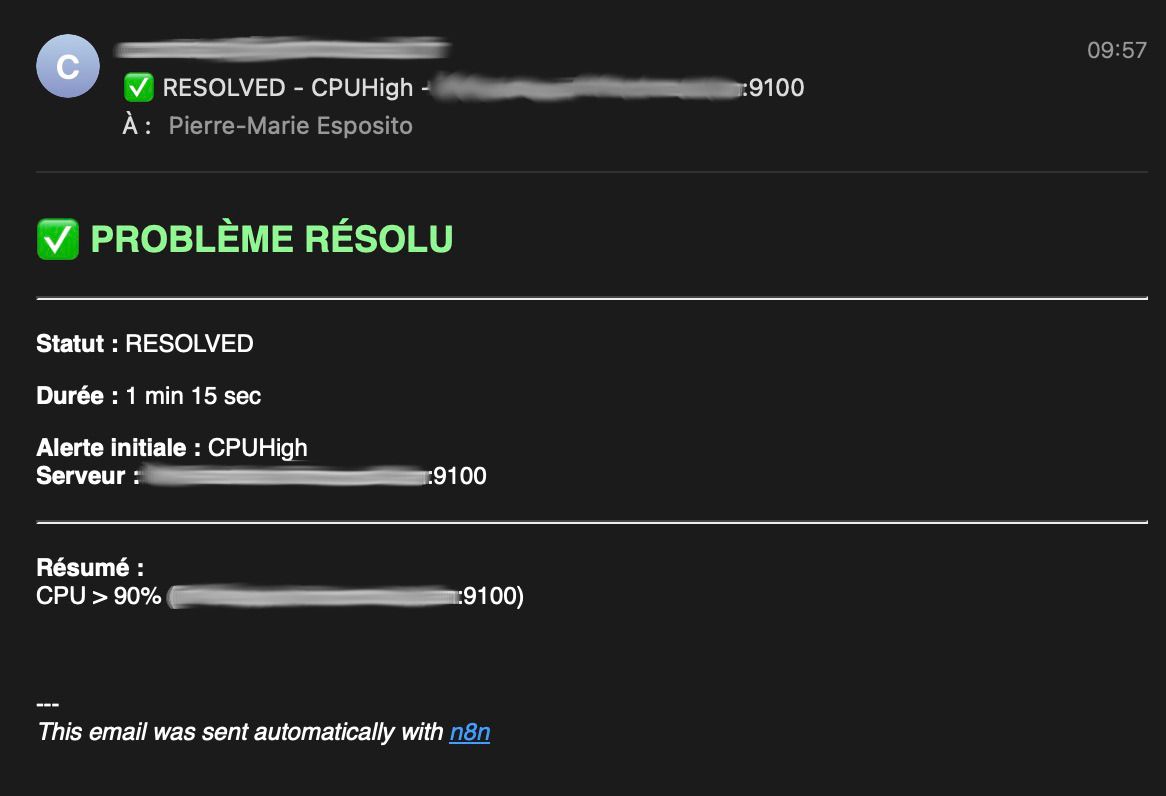
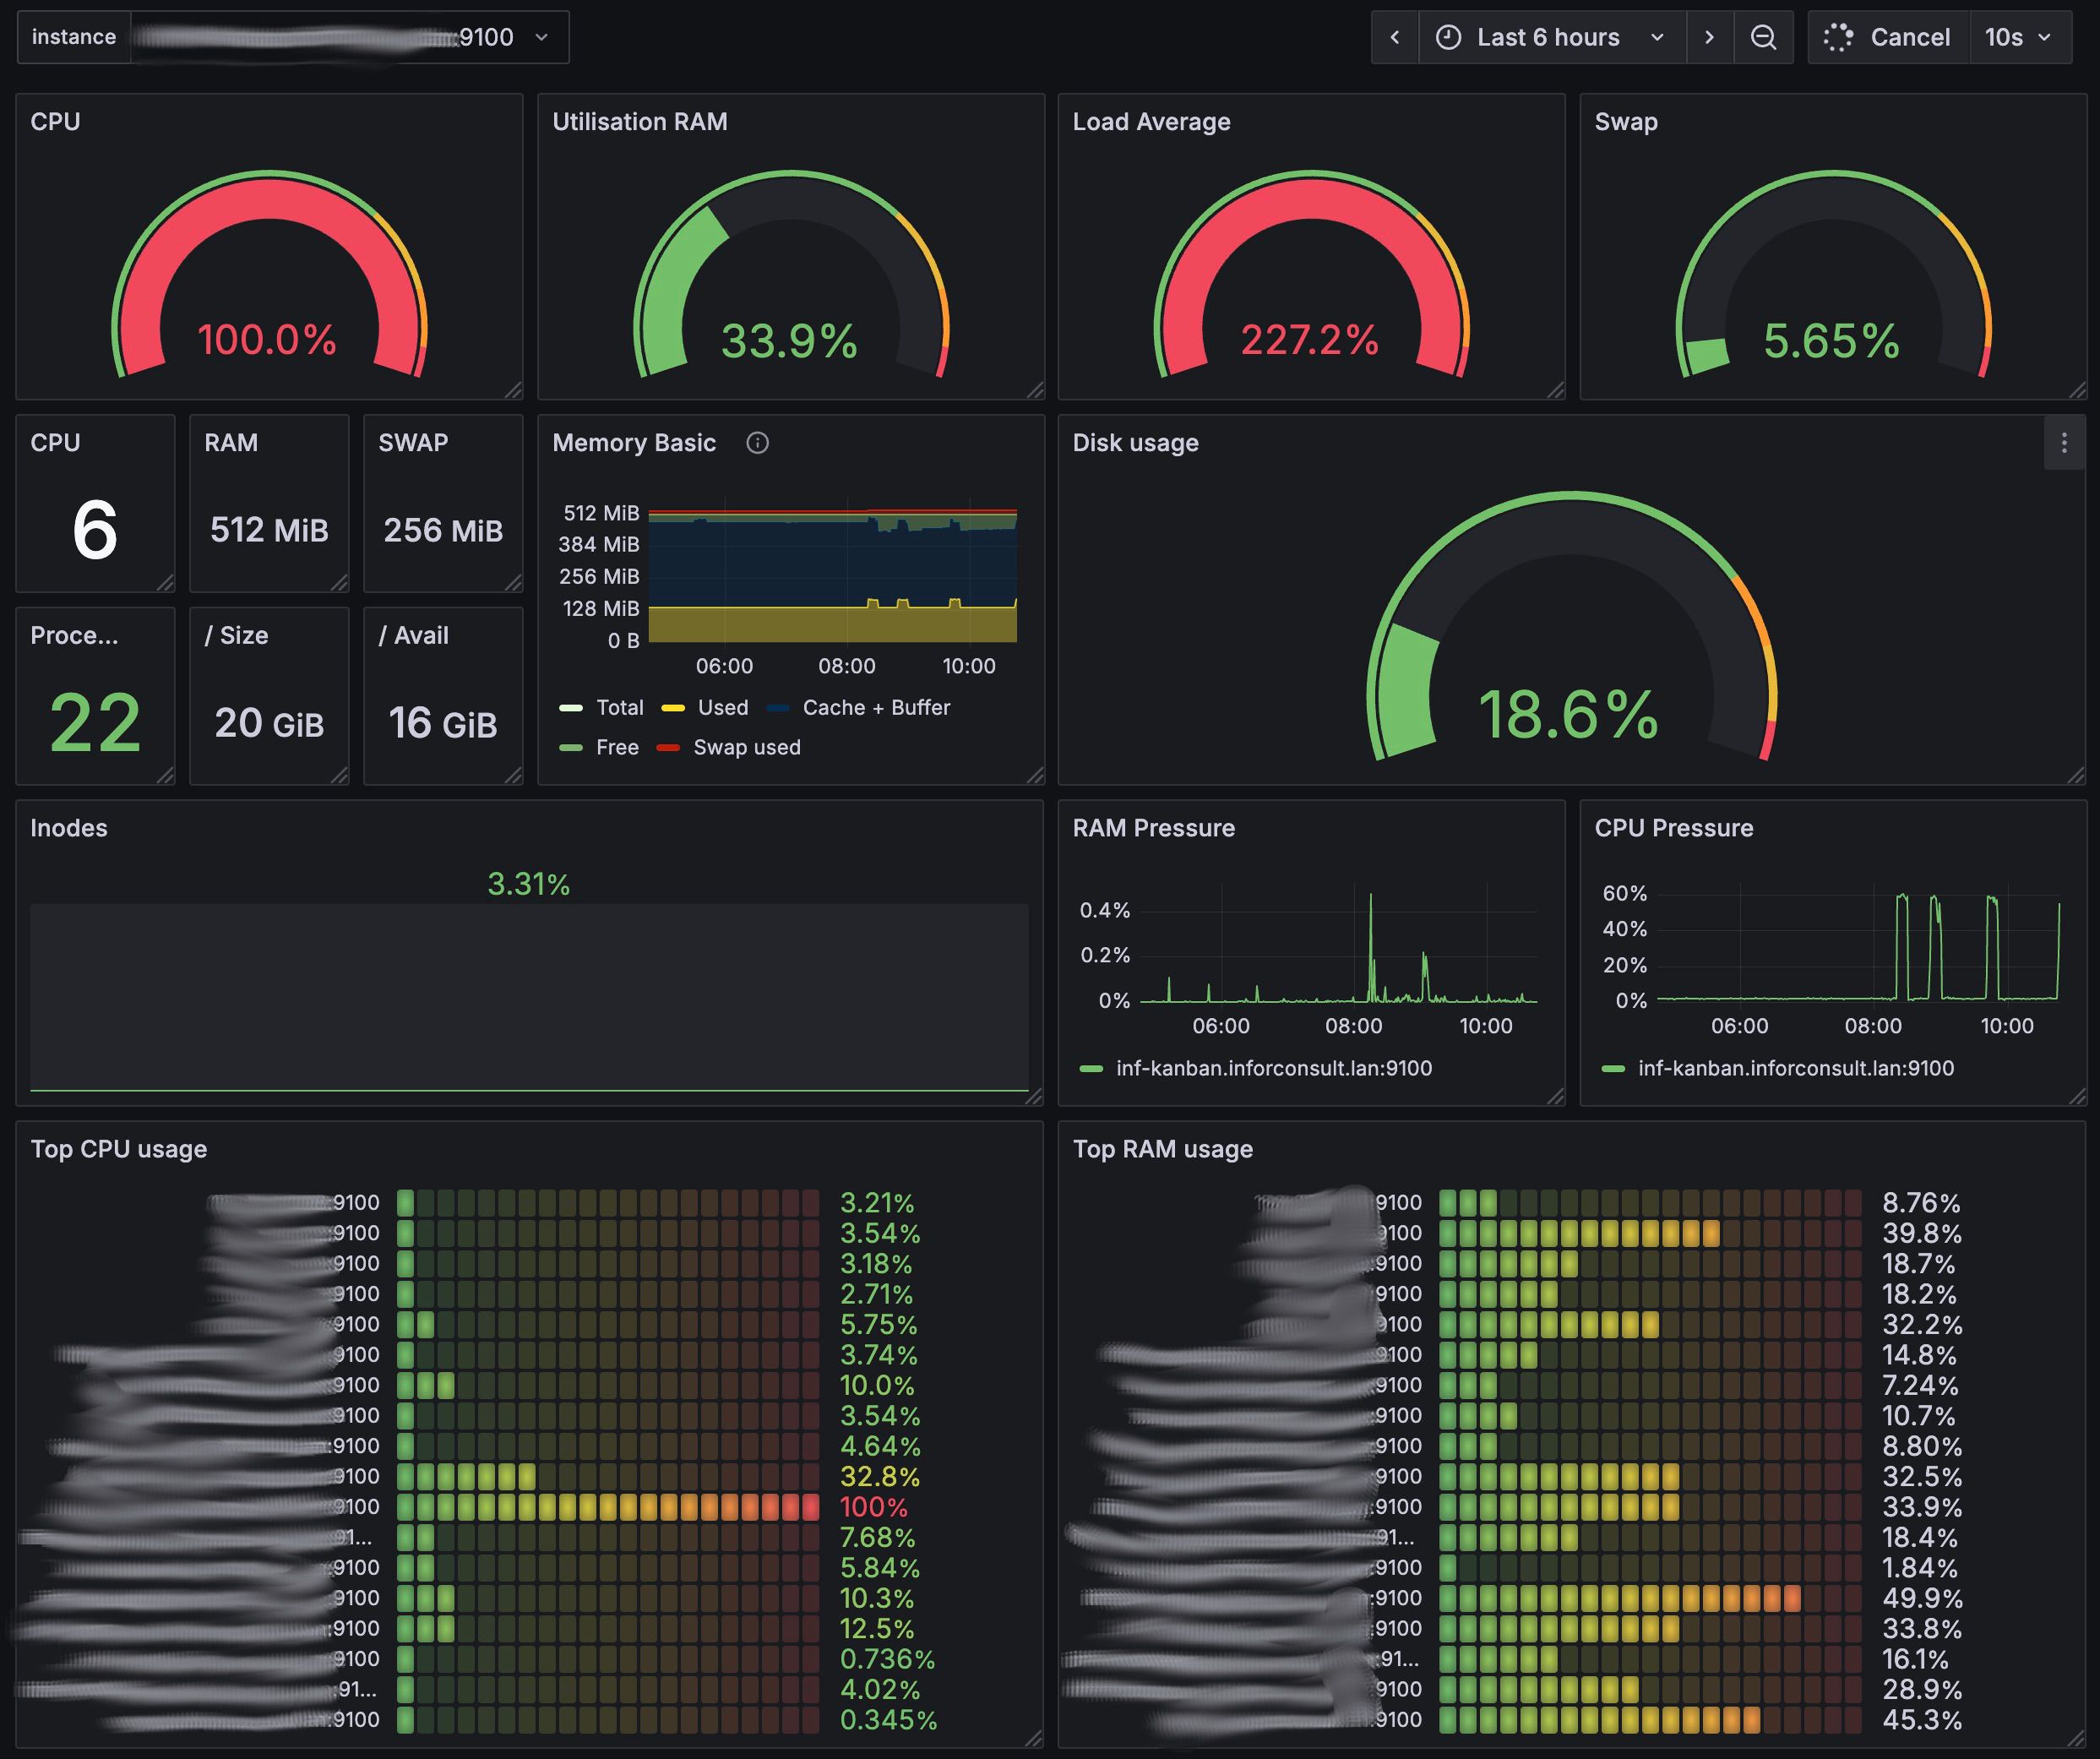
Test 2 : stress-test CPU d'un node

Email d'alerte enrichie par l'IA

Email de résolution avec MTTR

Déclenchement de l'alerte pour le test Pour valider la chaîne complète, le déclenchement de l'alerte a été provoqué par un stress-test CPU volontaire sur un conteneur de test. Ce type de sollicitation manuelle permet de vérifier le bon fonctionnement de bout en bout — du déclenchement Prometheus à la réception de l'email enrichi — sans attendre un incident réel. Le mail reçu montre d'ailleurs une valeur CPU à 100%, cohérente avec la charge artificielle injectée.

Intégration du LLM : choix et contraintes
Le choix d'un LLM auto-hébergé plutôt qu'une API cloud s'est imposé pour des raisons de souveraineté des données (les alertes contiennent des informations d'infrastructure interne) et de maîtrise des coûts. Ollama a été retenu pour sa simplicité de déploiement et son support natif de plusieurs modèles open source.

Le dimensionnement a nécessité quelques itérations. Un modèle 7B de paramètres, bien que plus précis dans ses analyses, s'est avéré trop lent en inférence CPU pure (30 secondes pour une phrase simple, plusieurs minutes pour un prompt de diagnostic complet). Le passage à un modèle plus léger (3.8B paramètres) a ramené le temps de réponse à quelques secondes, avec une qualité de diagnostic tout à fait exploitable pour ce cas d'usage. La différence de pertinence se manifesterait surtout sur des corrélations complexes entre logs — ce qui n'est pas le besoin principal ici, puisque les suggestions déterministes couvrent déjà les actions de remédiation classiques.

Le modèle LLM (phi3:mini) tourne sur une lxc sans GPU Nvidia, avec 16G de Ram 8vcpu et 40G de disque. Serveur proxmox : Intel Xeon-D 2141I - 8c/16t - 2.2 GHz/3 GHz / 64 Go ECC 2133 MHz / PVE8

Bénéfices pour les équipes techniques

Même si l'analyse reste à affiner — notamment sur la pertinence des requêtes Loki selon les types d'incidents et la profondeur des diagnostics IA — le gain est déjà perceptible. Les logs corrélés et la valeur temps réel réduisent la phase initiale d'investigation manuelle. Le technicien dispose de commandes de remédiation directement exploitables depuis l'email. Le diagnostic IA ajoute une couche d'interprétation en langage naturel qui peut aider un profil moins expérimenté à comprendre la situation. Le niveau de criticité calculé automatiquement (intégrant le volume de logs d'erreur) offre une meilleure priorisation que la severity statique de l'alerte. La fenêtre de 15 minutes montre ce qui s'est passé juste avant le déclenchement — souvent plus révélateur que l'alerte elle-même. La chaîne est fonctionnelle de bout en bout ; il s'agit maintenant de l'enrichir itérativement pour gagner en précision.

Bénéfices pour les décideurs

Au-delà de l'aspect technique, ce POC démontre plusieurs points à valeur business. Le MTTR (Mean Time To Resolve) devrait diminuer quand le diagnostic arrive avec l'alerte, même si ce gain reste à mesurer sur la durée. Les suggestions de remédiation — qu'elles soient déterministes ou générées par le LLM — codifient le savoir-faire de l'équipe : même un junior ou un prestataire reçoit les bonnes pistes sans dépendre d'un expert disponible. L'ensemble repose sur des briques open source (Grafana, Prometheus, Loki, n8n, Ollama) — le surcoût est uniquement du temps d'intégration, pas de licences.

Perspectives

Ce POC constitue une base fonctionnelle. Les évolutions envisagées : l'enrichissement du prompt LLM avec des extraits de logs Loki (actuellement le modèle reçoit uniquement le type d'alerte et la valeur métrique, les logs étant présents dans l'email mais pas transmis au LLM pour des raisons de performance en inférence CPU), l'intégration de l'historique des commandes récentes (via l'audit log ou le journal systemd) afin de corréler une alerte avec une action humaine — par exemple identifier qu'un pic CPU fait suite à un stress-test volontaire ou qu'un reboot a été déclenché manuellement, ce qui changerait radicalement le diagnostic à produire. D'autres pistes incluent l'extension aux alertes applicatives via les labels Loki dédiés aux services, une escalade intelligente vers un canal de communication d'équipe ou un runbook automatisé en cas de pattern critique détecté (OOM killer, I/O errors), un feedback loop permettant aux techniciens de valider ou corriger les diagnostics pour améliorer les suggestions futures, et le passage éventuel à un modèle plus puissant si les ressources le permettent (GPU dédié ou modèle quantifié).

Pierre-Marie Esposito

iaapp

Automatiser la recherche immobilière : retour d’expérience sur la conception d’un système de veille intelligent

Automatiser la recherche immobilière : retour d’expérience sur la conception d’un système de veille intelligent

🏡 Chercher un logement aujourd’hui est devenu un vrai second job. Rafraîchir Leboncoin, Bien’ici, PAP des dizaines de fois par jour… Trier, filtrer, éliminer les annonces hors sujet… Et malgré ça, passer à côté des meilleures opportunités. J’ai été confronté exactement à ce problème. Plutôt que d’y passer des heures chaque jour, j’ai conçu un système qui travaille pour moi 24h/24. 👉 L’idée : automatiser entièrement la veille immobilière, avec un filtrage réellement intelligent. Concrètement, le système : - surveille plusieurs plateformes en continu - applique plusieurs niveaux de filtrage (règles + IA) - ne remonte que les annonces réellement pertinentes Chaque annonce est analysée et scorée, ce qui permet d’éviter le bruit et de se concentrer uniquement sur ce qui vaut le coup. 🎯 Dès les premières utilisations, j’ai pu identifier rapidement plusieurs biens pertinents, là où une recherche classique m’aurait demandé plusieurs heures de tri. Ce que ça change concrètement : -…

Le problème que tout chercheur de logement connaît

Quiconque a déjà cherché un logement, à la location comme à l’achat, connaît cette routine rapidement chronophage : ouvrir Leboncoin, configurer la recherche, actualiser, scroller, passer à Bien'ici, recommencer, puis PAP… et répéter ce cycle plusieurs fois par jour pendant des semaines.

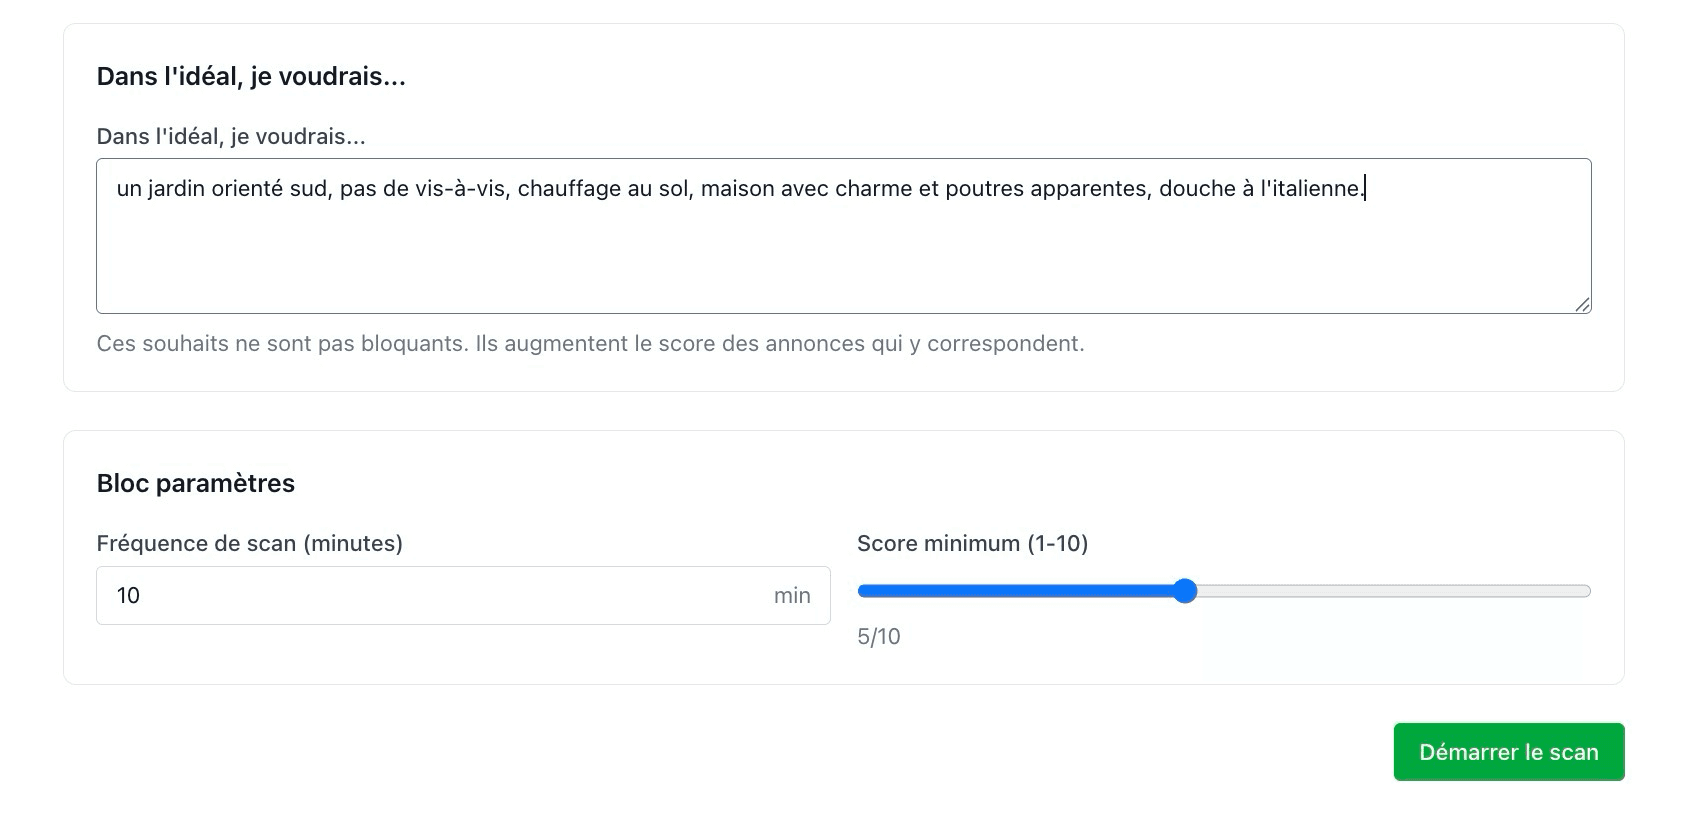
Les bonnes annonces partent souvent en quelques heures. Dans le même temps, les filtres proposés par les plateformes restent relativement limités : difficile, par exemple, d’exprimer des contraintes précises comme “jardin attenant d’au moins 250 m²” ou “exclure toute forme de colocation déguisée", "je cherche un jardin avec des palmiers", "je veux une salle de bain avec douche à l'italienne”.

Résultat : beaucoup de bruit, beaucoup de temps perdu, et des opportunités manquées.

Execution :


Concevoir un système pour automatiser la veille

Plutôt que d’optimiser marginalement cette recherche, j’ai choisi de changer d’approche : concevoir un système capable de la prendre en charge de manière autonome.

L’objectif n’était pas simplement d’agréger des annonces, mais de reproduire — et systématiser — un processus de sélection pertinent :

  • surveiller plusieurs sources en continu
  • filtrer rapidement ce qui est hors sujet
  • analyser finement le contenu restant
  • ne remonter que les annonces réellement intéressantes

Architecture générale

Le système repose sur un pipeline relativement simple dans sa logique, mais structuré pour être robuste et extensible :

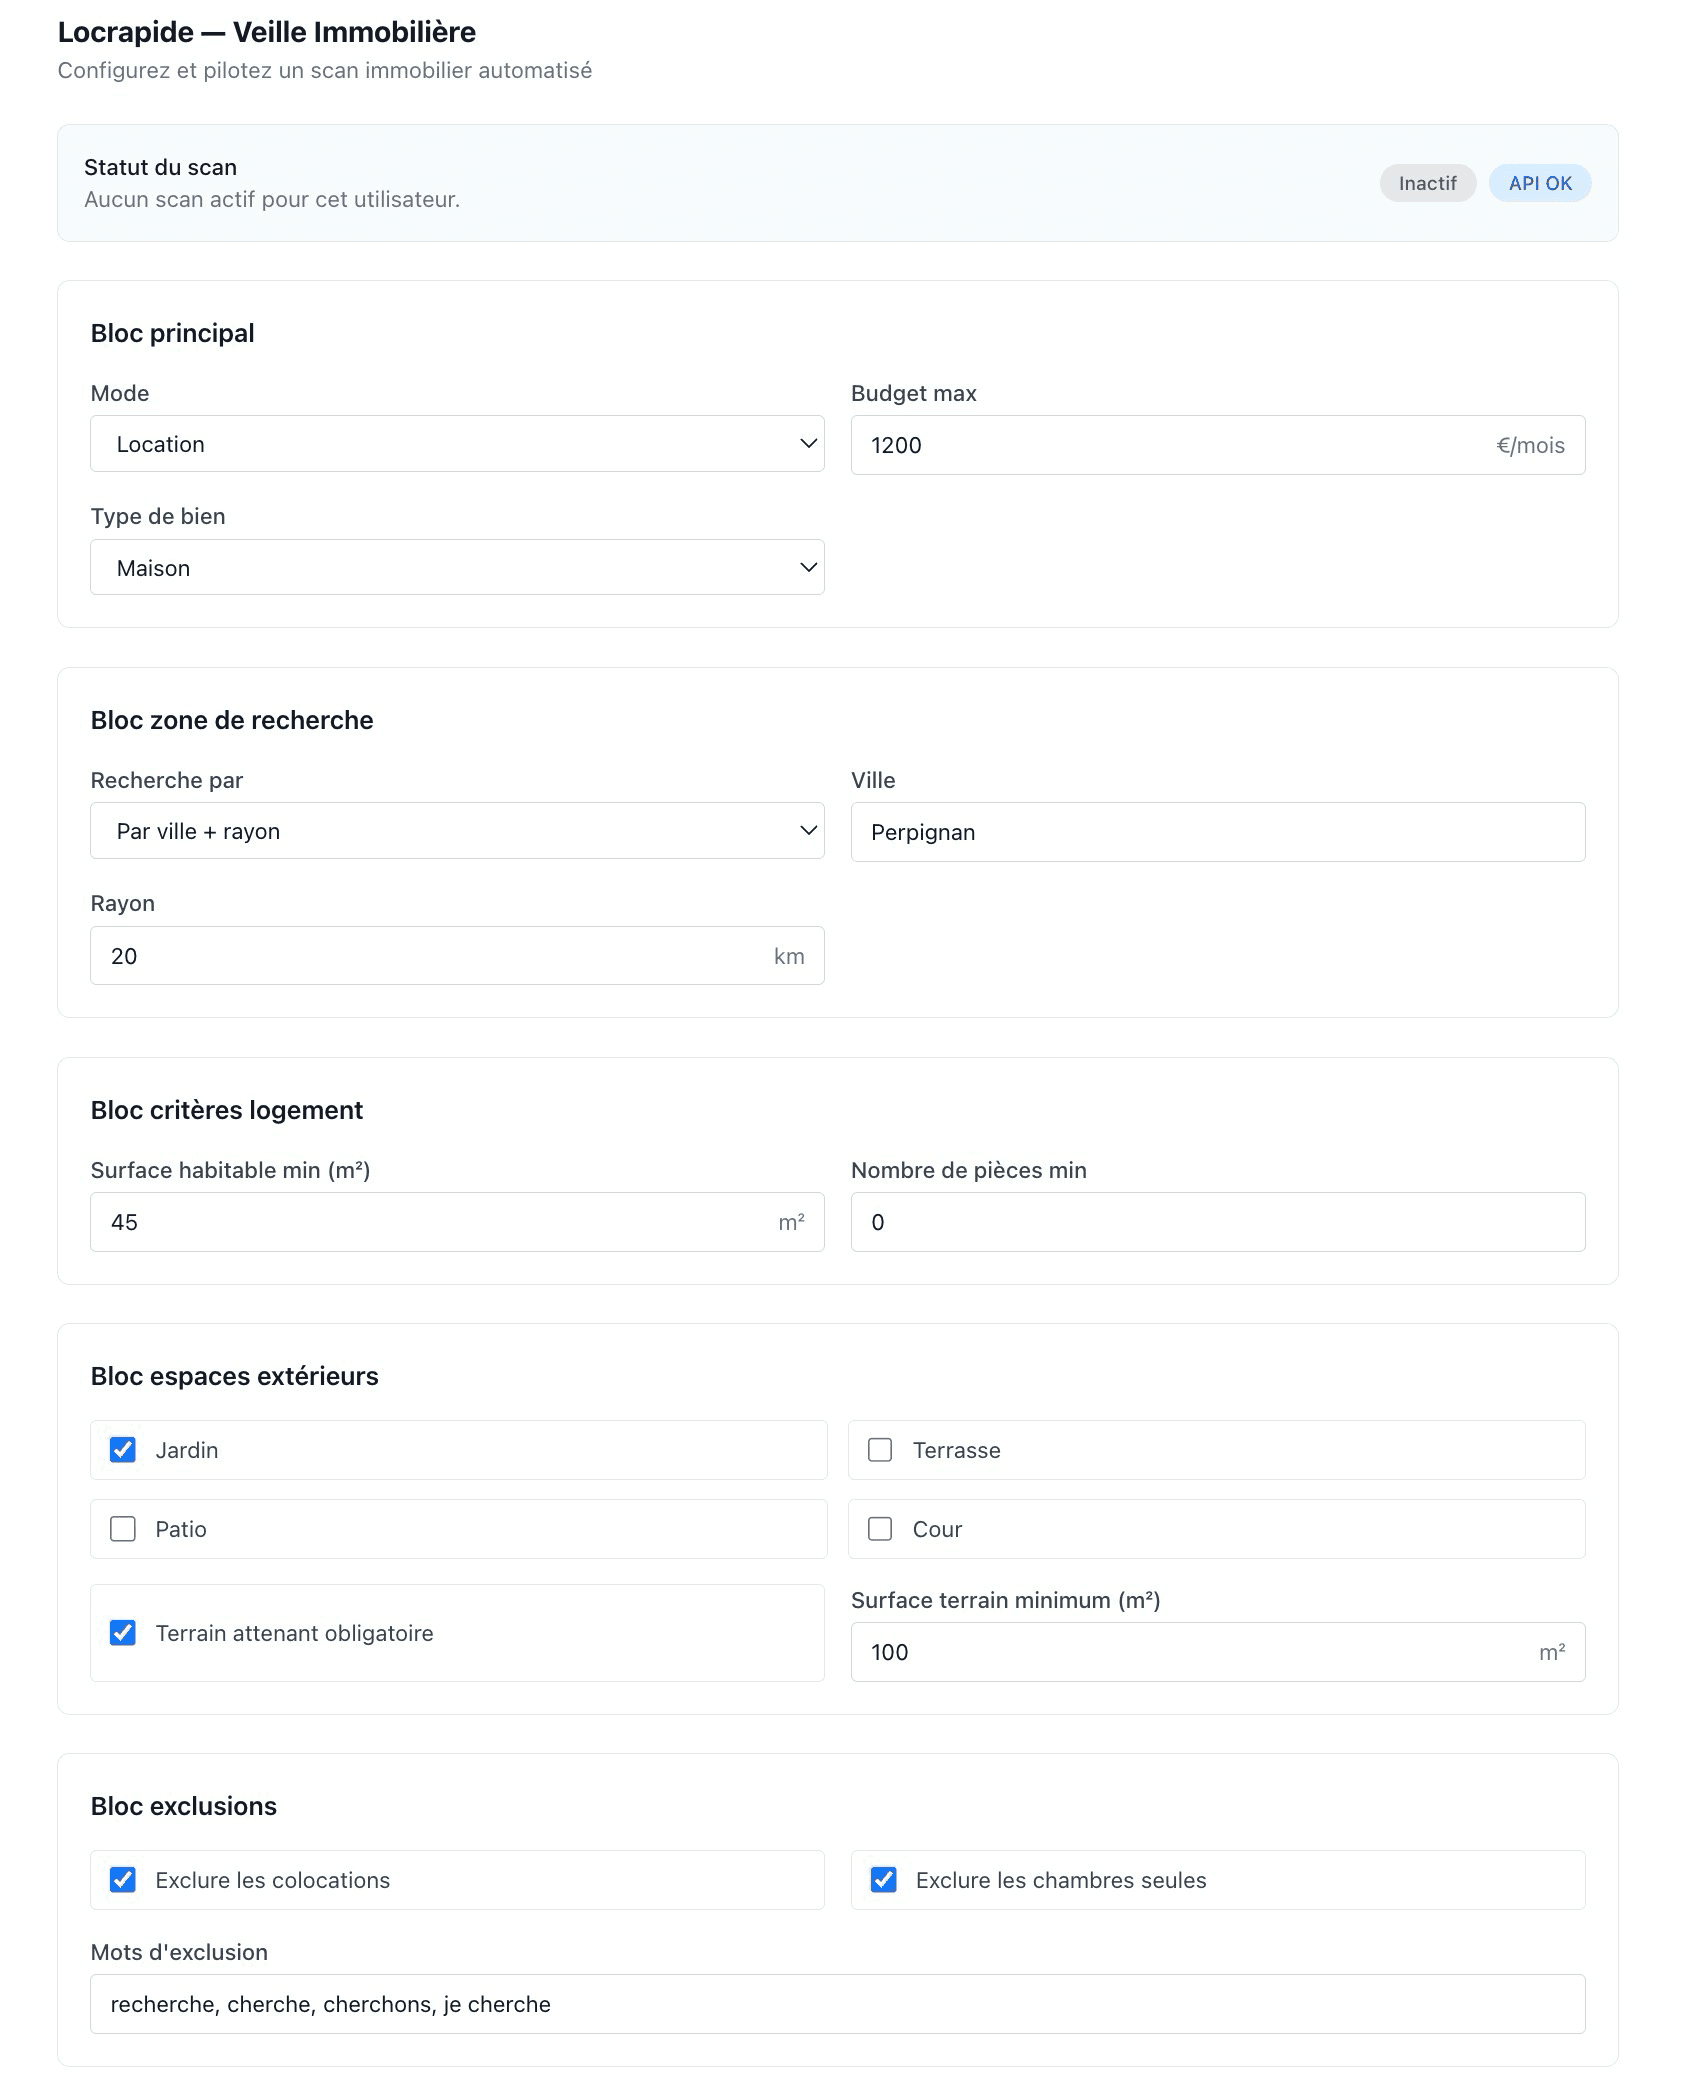
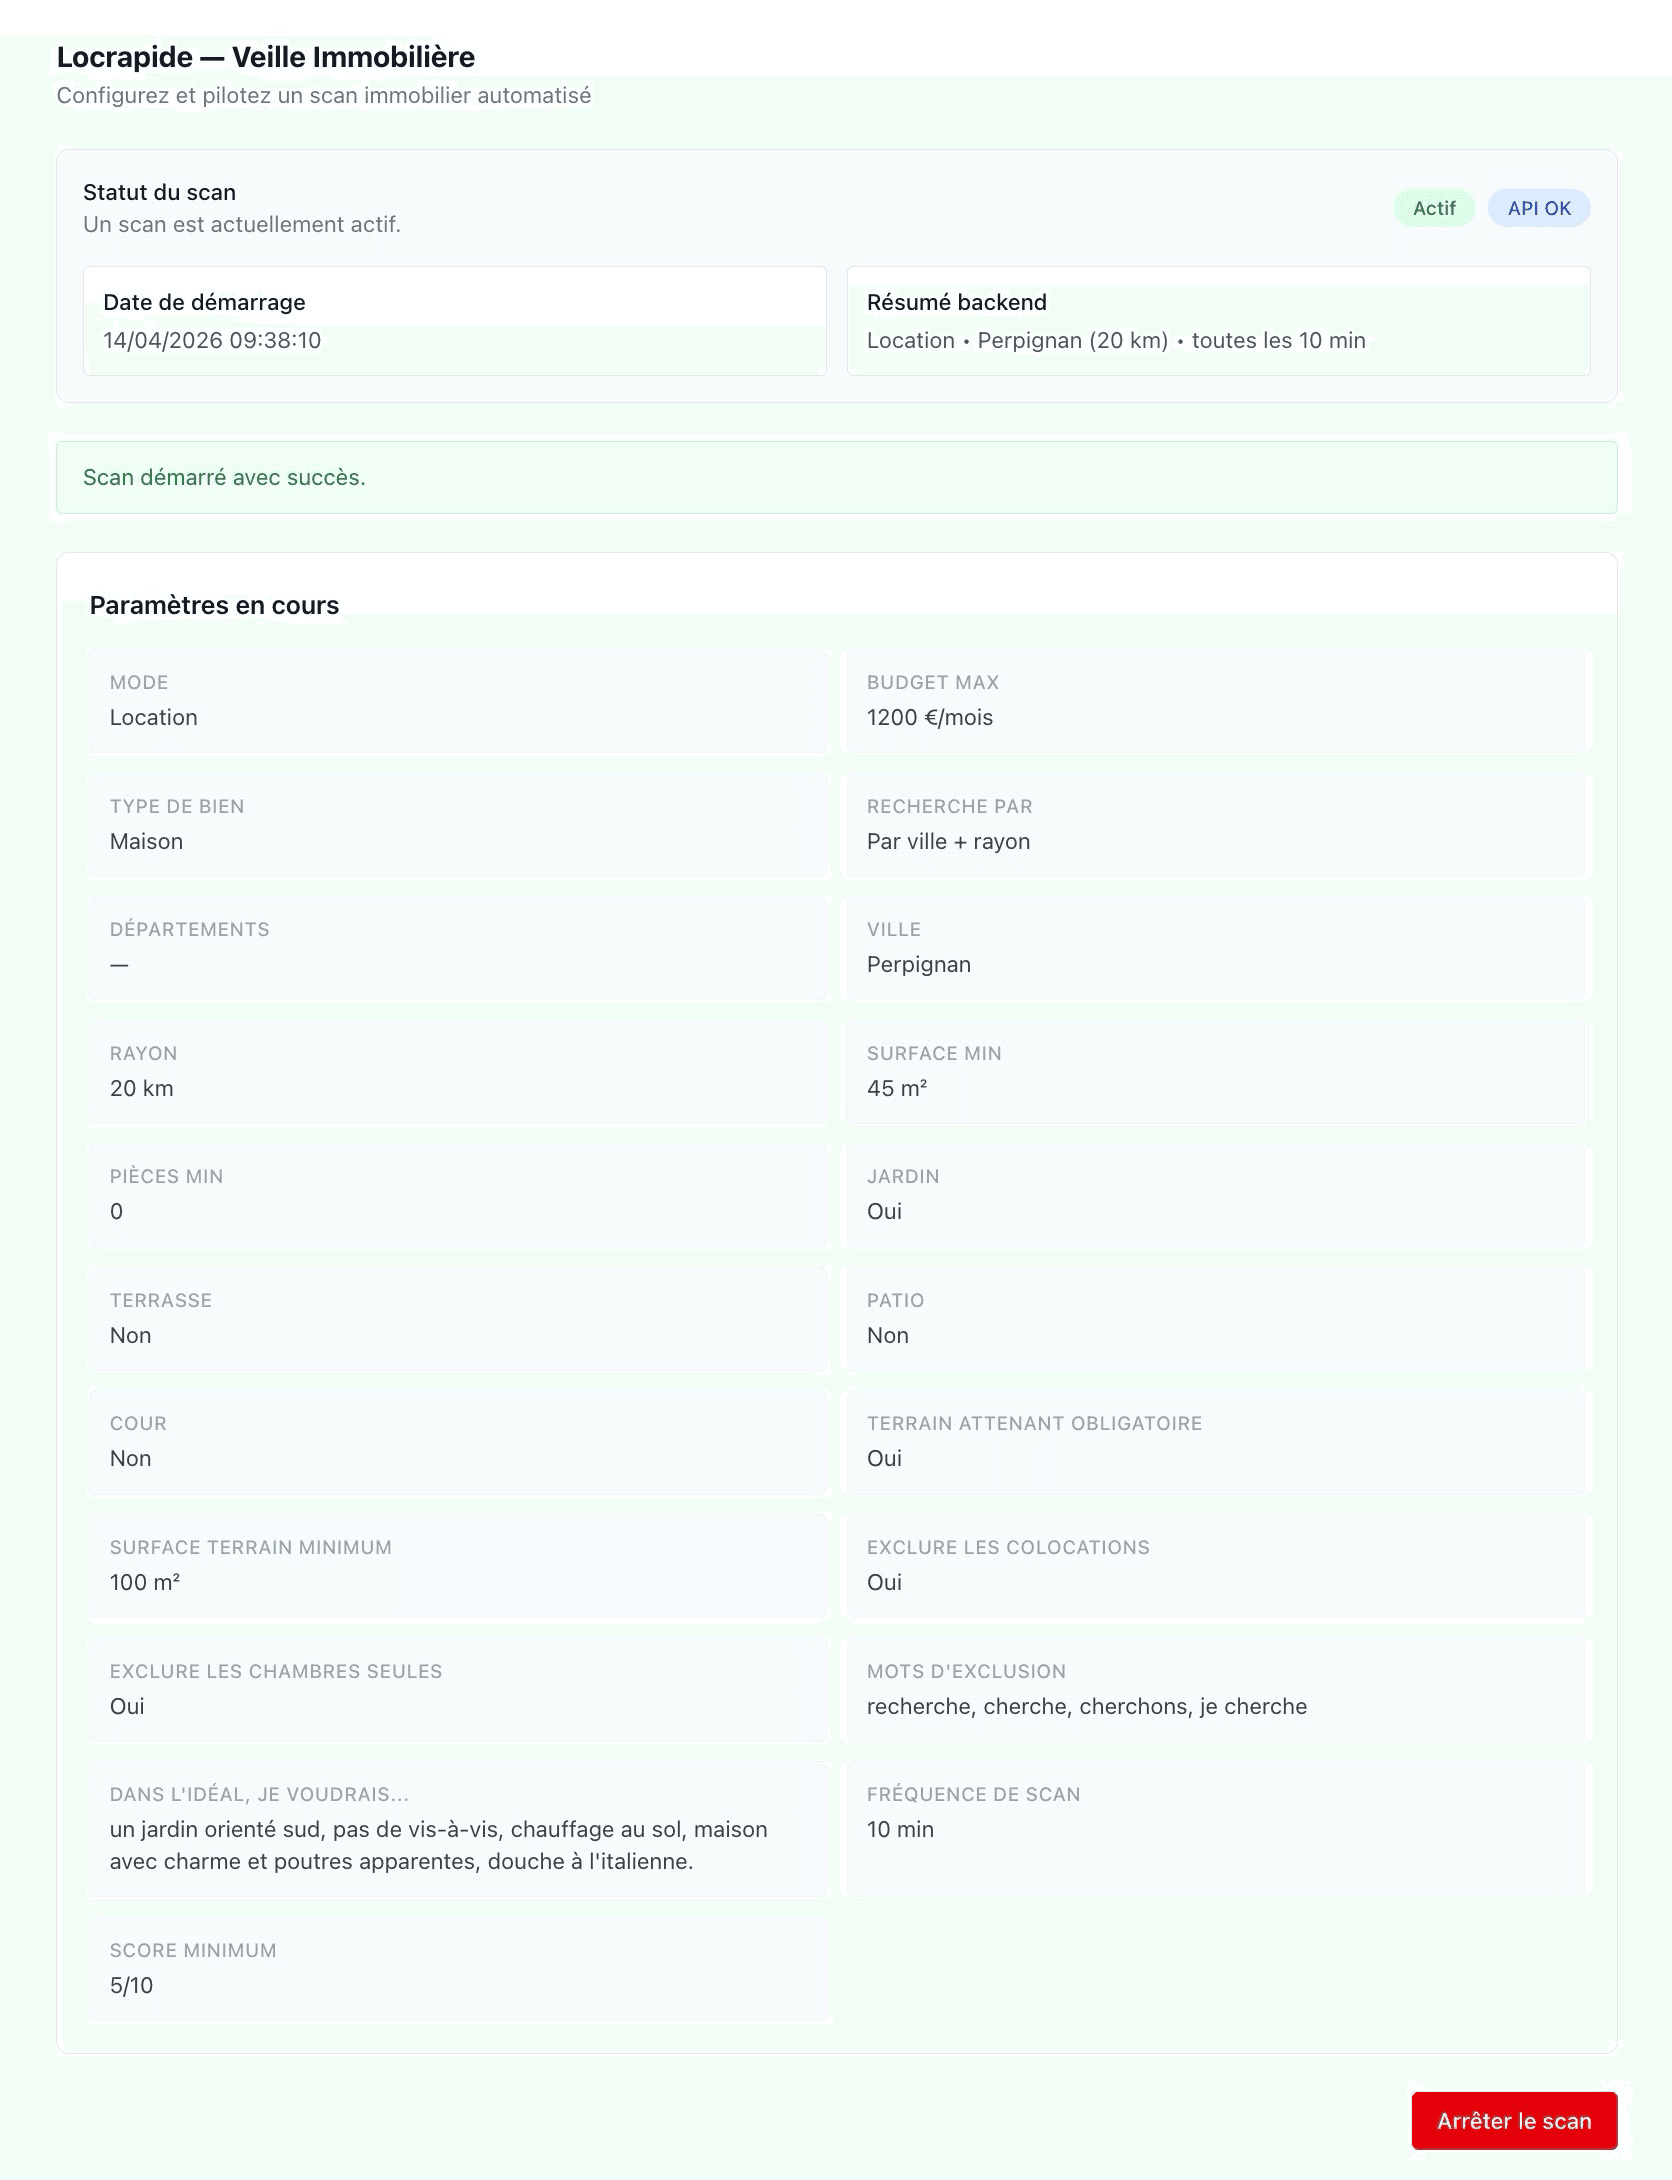
  1. Configuration des critères via une interface dédiée
  2. Surveillance continue de plusieurs sources
  3. Filtrage en plusieurs étapes
  4. Scoring intelligent des annonces
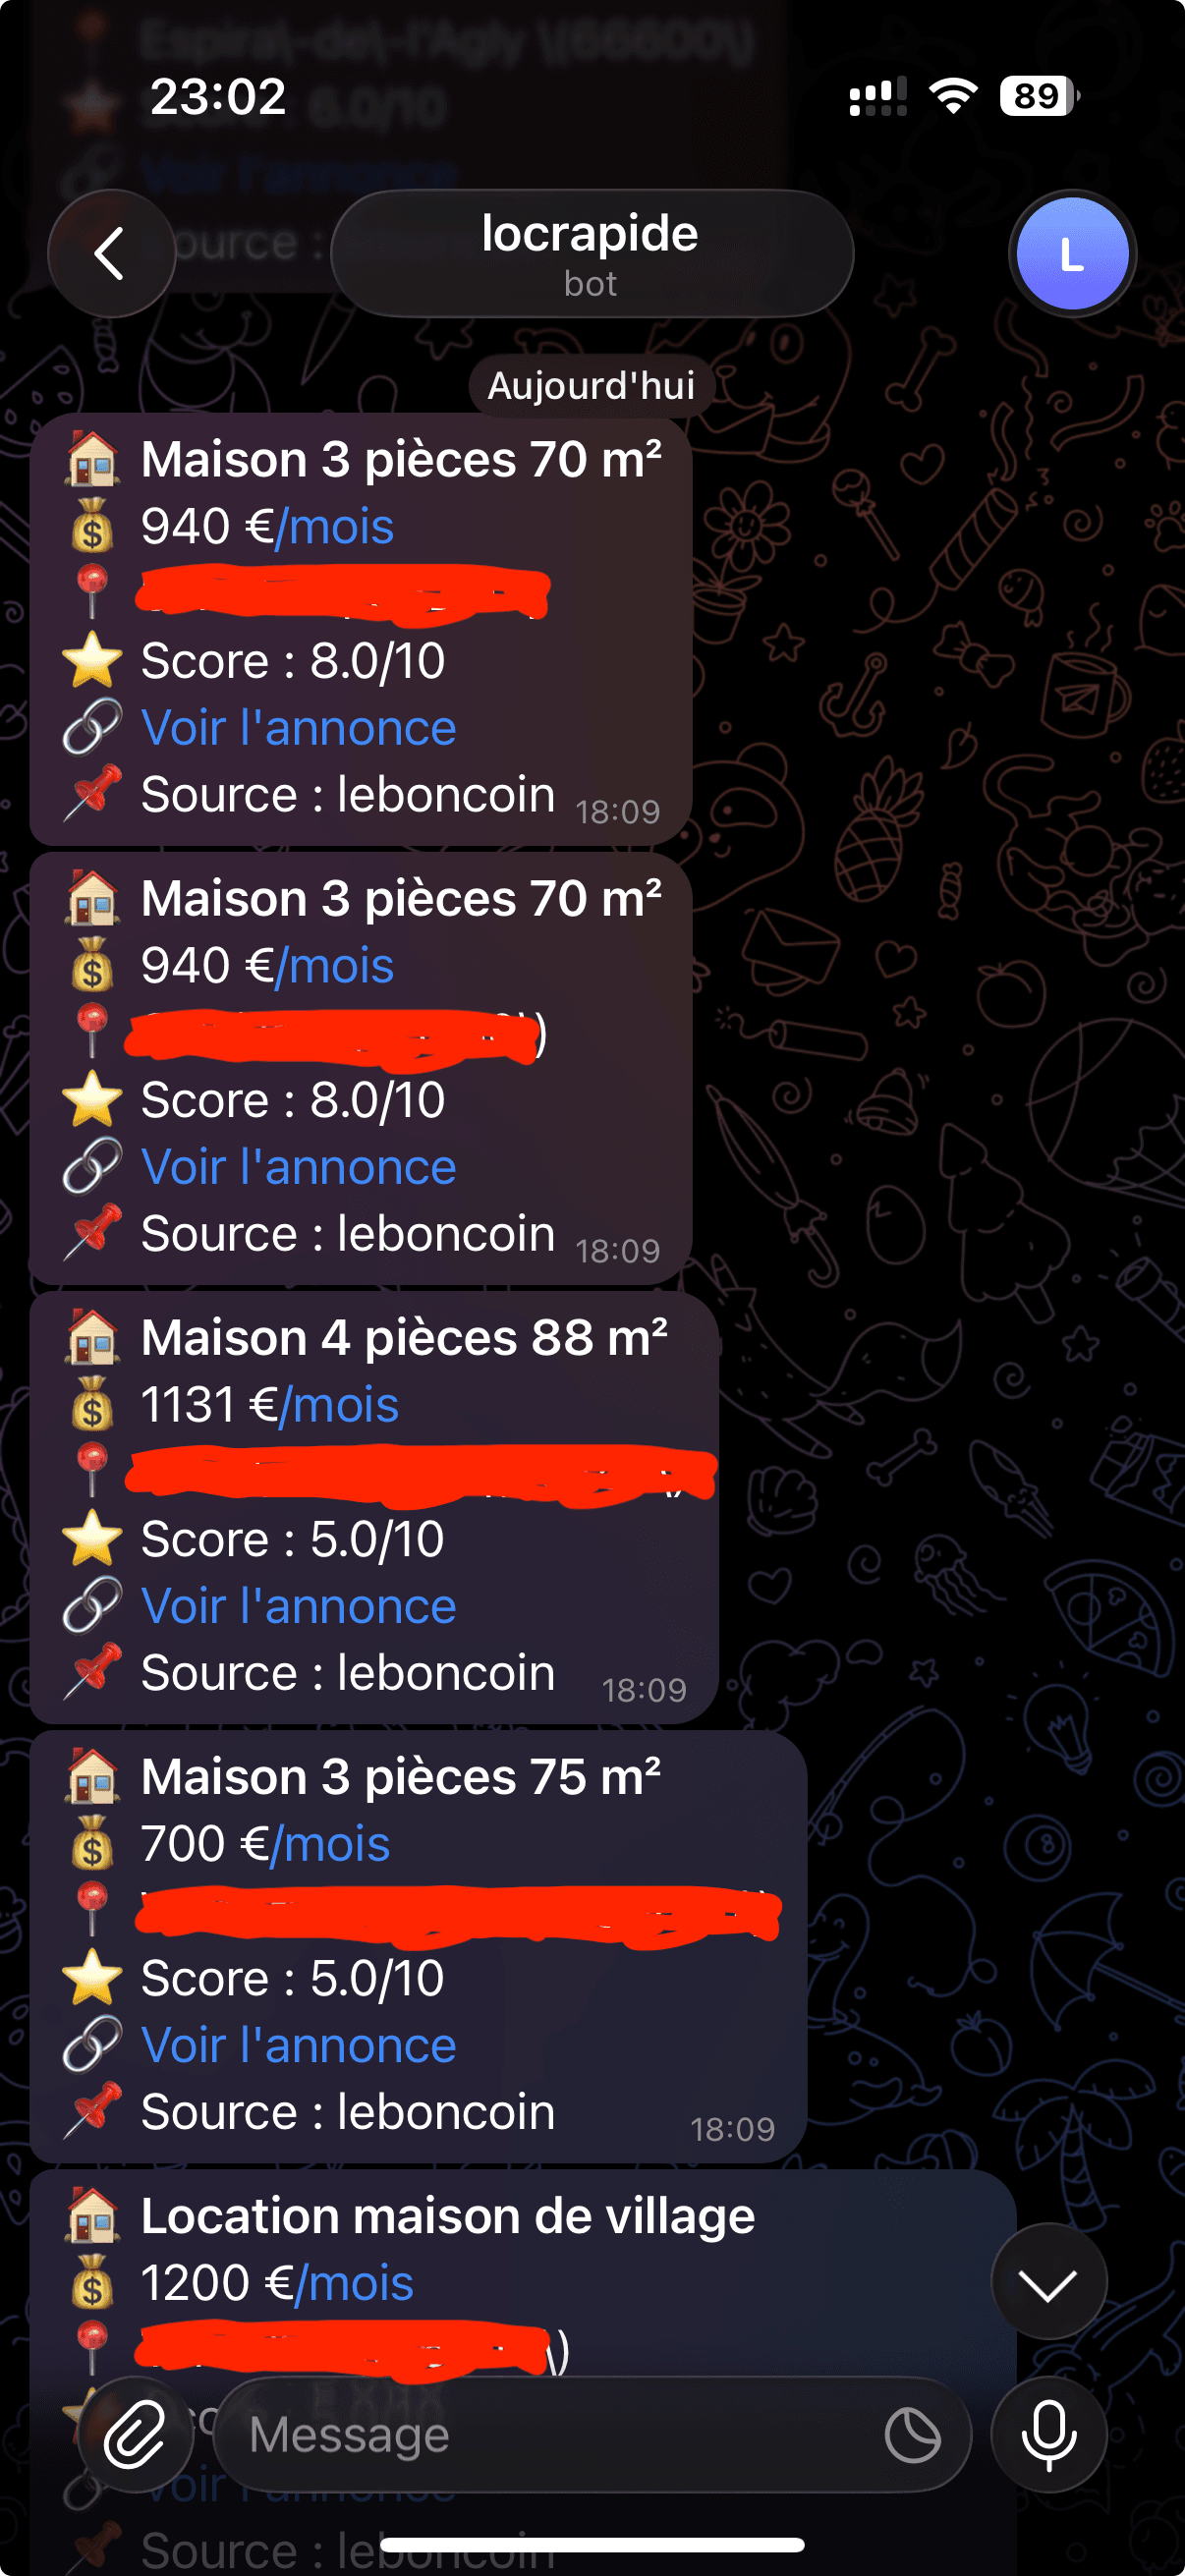
  5. Notification des résultats pertinents

Un filtrage en plusieurs niveaux

L’un des points clés est d’éviter de solliciter inutilement les modèles d’IA, tout en conservant un bon niveau de précision.

Pour cela, le traitement est découpé en trois étapes.

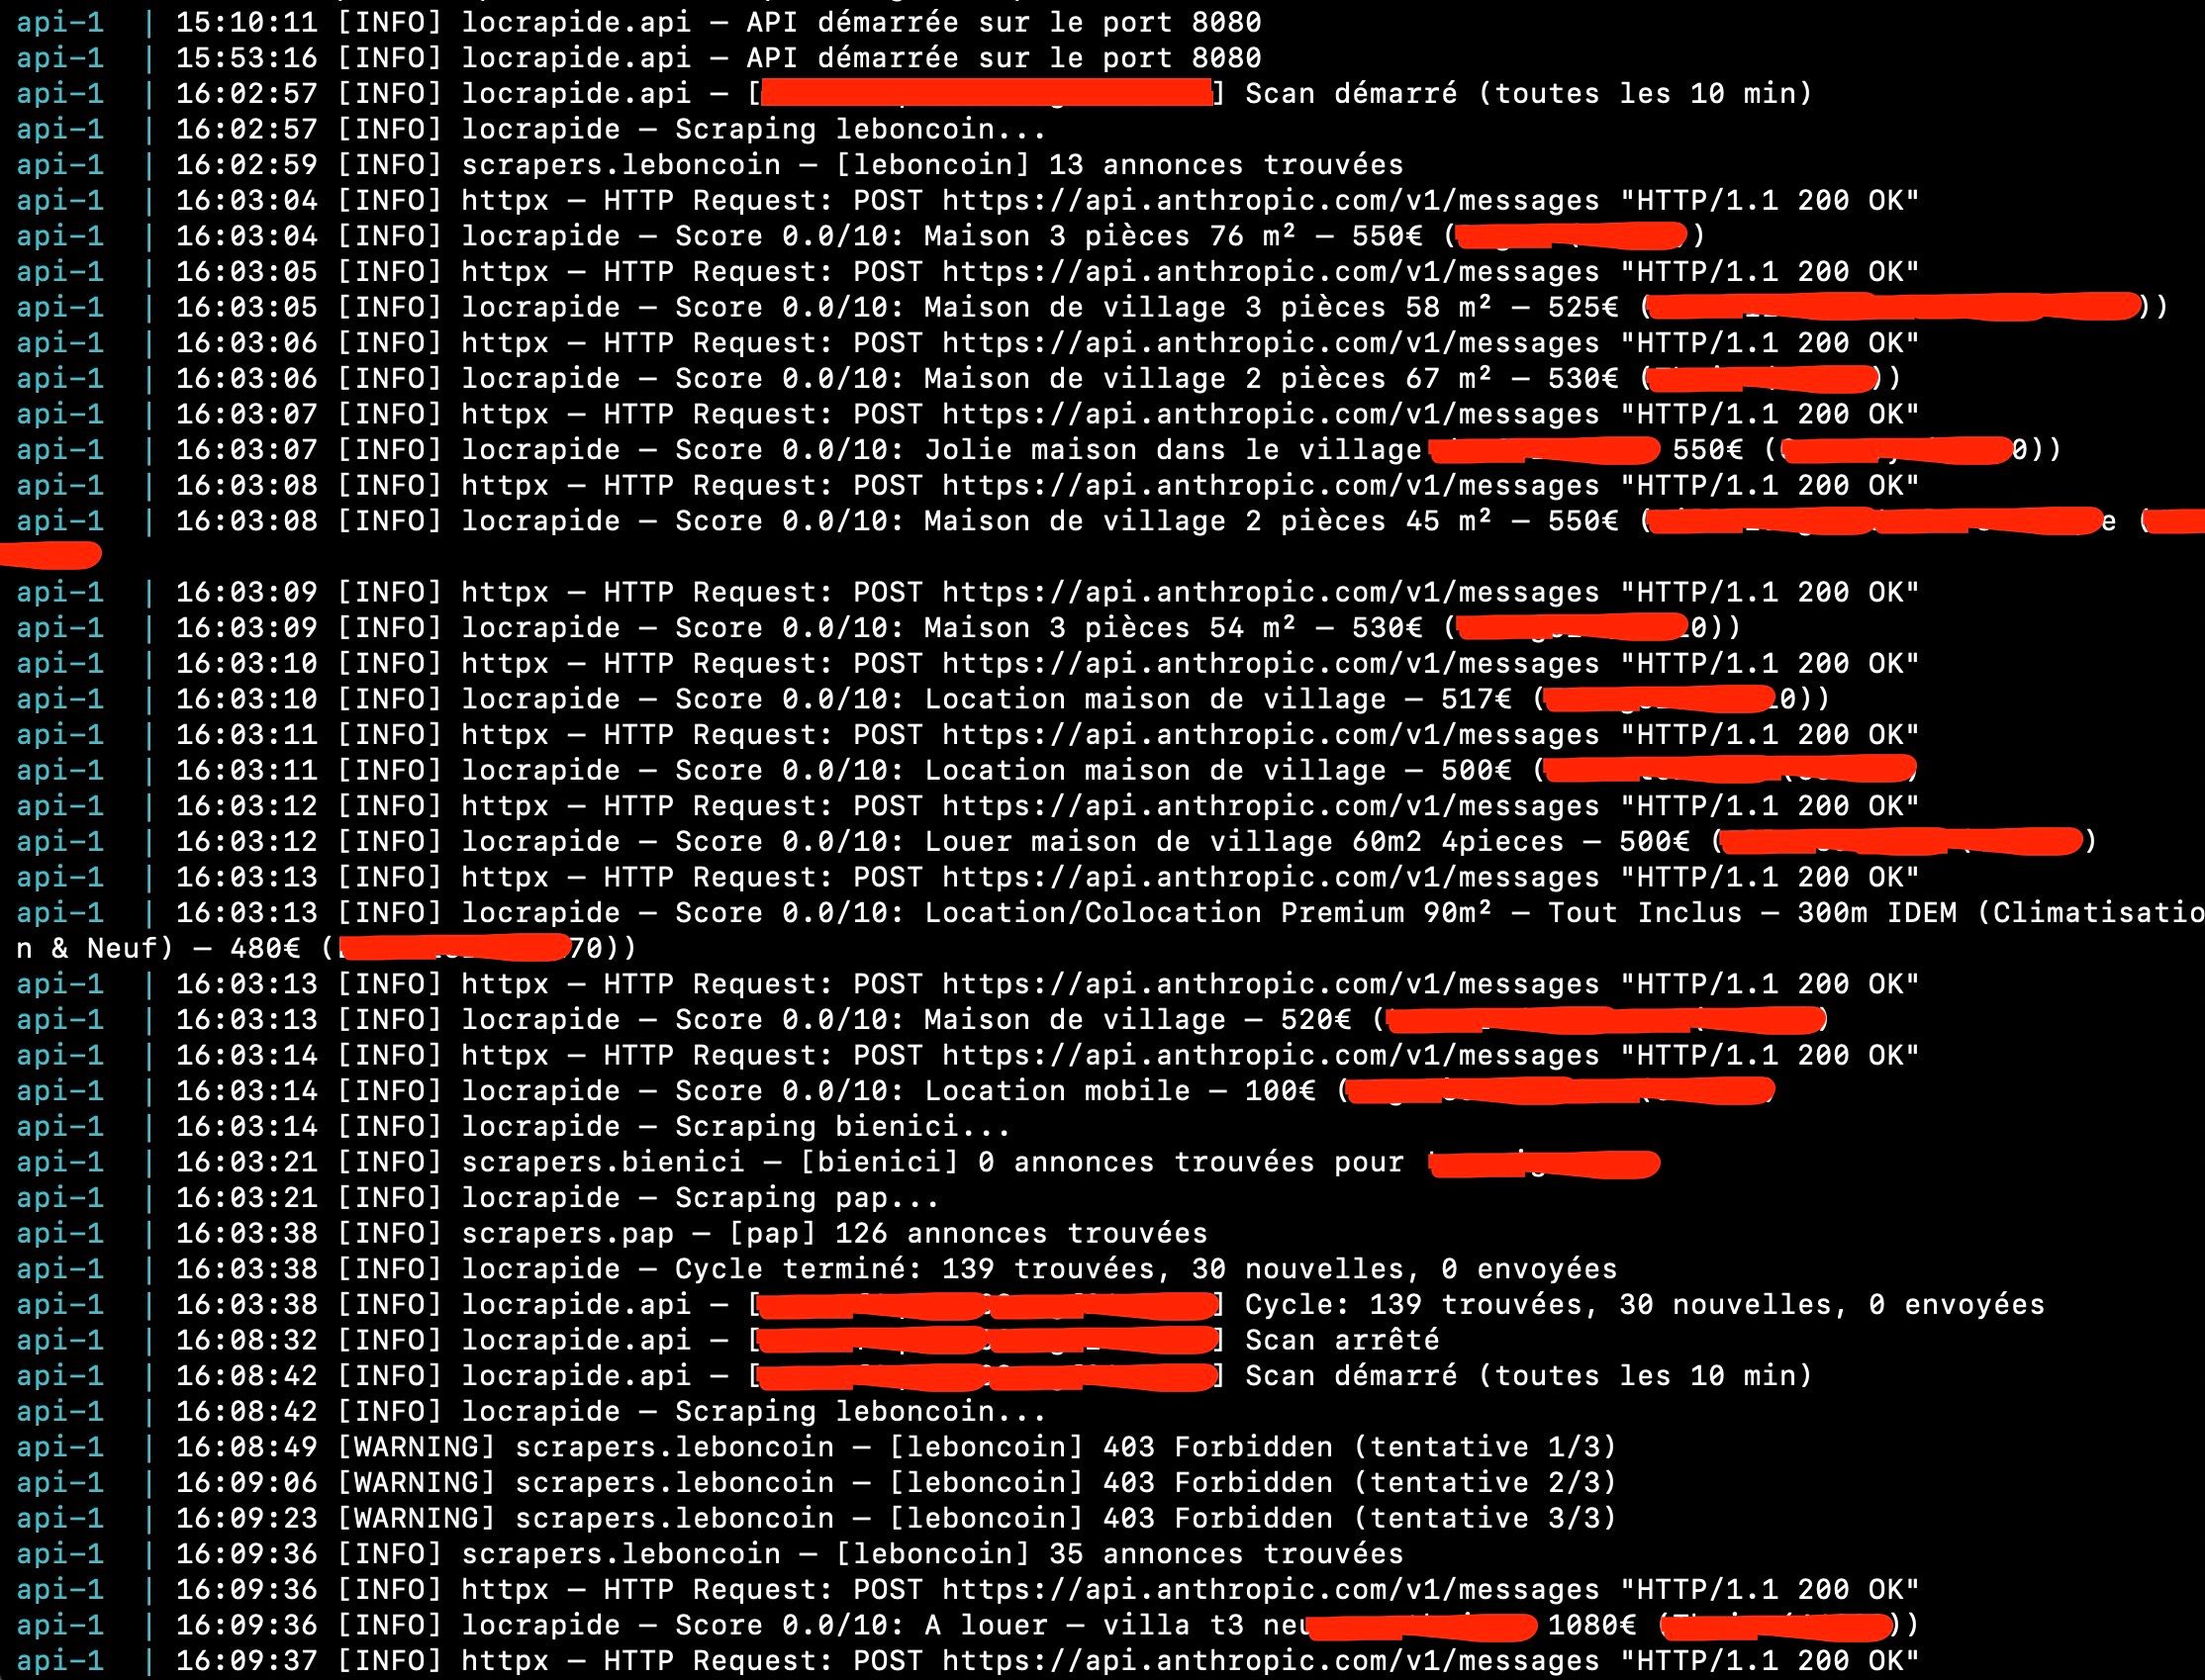
1. Pré-filtrage

Une première passe élimine immédiatement :

  • les annonces vides ou incomplètes
  • les “recherches de logement”
  • les contenus contenant des mots interdits
  • les biens hors zone géographique

Ce niveau permet de réduire fortement le volume à traiter.


2. Filtrage déterministe

Une seconde étape applique des règles simples :

  • prix
  • surface
  • nombre de pièces

Ce filtrage mécanique permet d’écarter rapidement les cas non pertinents sans coût supplémentaire.


3. Scoring via modèle de langage

Le cœur du système repose sur l’utilisation d’un LLM (ici Anthropic via le modèle Claude Haiku).

Chaque annonce restante est analysée à partir d’un prompt généré dynamiquement en fonction des critères utilisateur.

Le modèle attribue un score de pertinence de 0 à 10, permettant de hiérarchiser les résultats.

Un point important : le prompt n’est pas statique. Il est construit automatiquement à partir des contraintes définies, ce qui permet d’adapter finement l’analyse à chaque cas.


Collecte des données

Le système s’appuie sur plusieurs sources immobilières, chacune avec des modes d’accès et des contraintes techniques spécifiques.

Certaines plateformes exposent encore des endpoints JSON relativement exploitables avec des paramètres structurés, tandis que d’autres reposent sur des interfaces fortement protégées, avec des mécanismes de détection d’automatisation de plus en plus avancés.

Dans la pratique, cela se traduit par différents cas de figure :

  • accès via API interne avec validation des paramètres de requête
  • pages HTML nécessitant une interprétation côté navigateur
  • protections anti-bot reposant sur la détection d’IP, l’analyse comportementale ou l’exécution de JavaScript

👉 Tous ces éléments rendent la collecte de données non triviale, et surtout évolutive dans le temps.


Gestion des contraintes anti-automatisation

Les plateformes immobilières utilisent aujourd’hui des solutions spécialisées pour limiter les accès automatisés (WAF, challenges JavaScript, détection d’IP de datacenter, etc.).

Ces mécanismes introduisent des contraintes fortes :

  • un comportement acceptable depuis une IP résidentielle peut être bloqué depuis une infrastructure serveur
  • certaines pages nécessitent l’exécution de JavaScript pour être accessibles
  • des endpoints peuvent être modifiés, restreints ou supprimés sans préavis

Stratégies d’adaptation

Pour garantir la robustesse du système, plusieurs approches sont envisagées selon les sources :

  • utilisation de proxys adaptés pour rapprocher le trafic d’un usage réel
  • recours à des navigateurs headless pour reproduire fidèlement le comportement d’un navigateur
  • adaptation dynamique des patterns de requêtes et des fréquences d’appel

Chaque solution implique des arbitrages entre :

  • performance
  • coût
  • complexité
  • maintenabilité

Gestion des doublons et architecture

Chaque utilisateur dispose de sa propre base SQLite, ce qui permet de garantir qu’une annonce ne soit jamais envoyée deux fois.

L’ensemble est déployé dans une architecture simple mais cloisonnée :

  • backend Python exposé via API REST
  • exécution dans un conteneur Docker
  • hébergement sur une LXC Proxmox
  • interface de configuration isolée en DMZ

Stack utilisée : Python 3.12, LLM (Claude Haiku), Telegram Bot, SQLite, Docker, Proxmox, VyOS.


Enseignements

Après les premières itérations, plusieurs points se dégagent.

  • Le scoring via LLM est très efficace, mais extrêmement dépendant de la qualité du prompt. Le calibrage est un sujet en soi.
  • Introduire une “zone grise” (scores intermédiaires) permet de ne pas rater des opportunités lorsque les descriptions sont incomplètes.
  • Générer dynamiquement les prompts à partir d’une interface utilisateur simplifie fortement l’usage tout en conservant de la précision.
  • La modularité des scrapers est essentielle : les sources évoluent régulièrement, et chaque connecteur doit pouvoir être adapté indépendamment, notamment face aux mécanismes de protection anti-automatisation qui évoluent en permanence.

Un pattern applicable à d’autres cas

Au-delà du cas immobilier, ce type d’architecture correspond à un schéma plus général :

👉 veille multi-sources + filtrage progressif + scoring intelligent

Ce pattern peut s’appliquer à de nombreux contextes :

  • veille concurrentielle
  • sourcing de leads
  • détection d’opportunités (marché, recrutement, data…)
  • tri automatisé de contenus à forte volumétrie

Ouverture

Ce projet est avant tout un cas concret d’application de l’automatisation et des modèles de langage à un problème réel.

Il illustre surtout une approche : structurer un flux de données, réduire le bruit progressivement, et n’appliquer l’intelligence que là où elle apporte réellement de la valeur.

💬 Si vous travaillez sur des problématiques similaires (veille, filtrage, automatisation, IA), ou que vous avez besoin de concevoir ce type de système sur mesure, je serai ravi d’échanger.

ia

Comment j’ai automatisé la publication de mon blog vers LinkedIn et Facebook (100% self-hosted)

Comment j’ai automatisé la publication de mon blog vers LinkedIn et Facebook (100% self-hosted)

Petit retour d’expérience après la mise en place de mon propre pipeline de publication. J’ai récemment construit une architecture simple mais efficace pour automatiser la diffusion de contenu. Objectif : Publier une seule fois… et distribuer automatiquement sur plusieurs canaux. 👉 Concrètement : Saisie du contenu via un frontend interne (Workflow Manager) Envoi vers Strapi, utilisé comme CMS central À la publication : → un webhook met à jour le blog → un second webhook déclenche un workflow n8n → réception d’un email pour valider (ou non) la publication → génération automatique des tags via OpenAI → publication automatique sur LinkedIn et Facebook après validation 👉 Stack utilisée : 🖥️ Hébergement LXC sur Proxmox VE 🧩 Strapi ⚙️ n8n 💻 Frontend custom 🔗 Webhooks pour l’orchestration 🤖 IA pour l’enrichissement du contenu 👉 Résultat : ✔ Une seule source de vérité ✔ Publication multi-canaux automatisée ✔ Validation humaine avant diffusion ✔ Enrichissement automatique via I…

Graphique publication contenu

1. Pipeline global

Pipeline

2. Infrastructure (self-hosted)

Stack globale

  • Hyperviseur : Proxmox VE
  • Conteneurisation : LXC
  • Segmentation réseau : firewall (type VyOS ou équivalent)

Segmentation minimum recommandée :

  • LAN : administration
  • DMZ :firewall
    • - n8n
    • - site web public
  • Zone interne :
    • - Strapi
    • - SaaS (Next.js)

👉 Objectif :

  • - Strapi non exposé publiquement
  • - n8n exposé uniquement pour les webhooks
  • - séparation stricte des flux

3. SaaS (Frontend de rédaction)

Stack

  • Framework : Next.js
  • Éditeur : recommandé → TipTap ou Slate.js

Fonction

Interface interne permettant :

  • - création d’articles
  • - édition riche (WYSIWYG)
  • - envoi vers Strapi via API REST

Logique

  1. L’utilisateur rédige un articleLe contenu est structuré (JSON ou HTML)
  2. Envoi via API vers Strapi : validation
    • titre
    • contenu
    • image
    • statut = draft ou published

4. Strapi (CMS central)

Stack

  • CMS : Strapi
  • LXC dédiée

Rôle

Source de vérité unique

Contient :

  • articles
  • images
  • statuts de publication
  • métadonnées (tags, SEO…)

Configuration clé

a. Content Type

Créer un type Article : content

  • title (string)
  • content (rich text)
  • slug (pour le lien direct article)
  • tags (relation ou string)
  • labels (pour classement sur le site)

b. Webhook

Configurer un webhook :

  • trigger : entry.publish
  • destination : n8n (URL publique DMZ)

5. n8n (orchestration)

Stack

  • Outil : n8n
  • Déployé en DMZ

Rôle n8n

Cœur du système :

  • - réception webhook Strapi
  • - transformation des données
  • - enrichissement
  • - validation
  • - publication multi-plateformes

6. Workflow n8n (logique détaillée)

Étapes

a. Webhook (entrée)

  • - reçoit payload Strapi
  • extrait :
    • - titre
    • - contenu
    • - image

b. Séparation contenu (Javascript)

  • texte
  • image

👉 permet :

  • gestion spécifique par plateforme
  • optimisation formats

c. Enrichissement via IA

  • API : OpenAI

Utilisation :

  • - génération de hashtags

d. Validation (critique)

Envoi d’un email :

email
  • contenu généré
  • liens de validation :
    • ✅ publier
    • ❌ annuler

👉 permet de garder le contrôle humain


e. Publication

Après validation :

LinkedIn
  • - API officielle
  • - publication sur page personnelle avec commentaire engagement

Facebook

  • - Graph API
  • - publication sur page entreprise avec commentaire engagement

7. Intégration LinkedIn

Plateforme

  • LinkedIn

Étapes

  1. Créer une app LinkedIn Developer
  2. Obtenir :
    • client ID
    • client secret
  3. Générer un token avec scopes :
  • w_member_social
  • r_liteprofile
  • r_emailaddress
  1. Associer la page entreprise

👉 Attention : LinkedIn est restrictif → validation de l’app nécessaire


8. Intégration Facebook

Plateforme

  • Meta

Étapes

  1. Créer une app Meta Developer
  2. Ajouter produit : Facebook Login
  3. Générer un token long-lived

Permissions nécessaires :

  • pages_manage_posts
  • pages_read_engagement
  1. Récupérer :
  • - page ID
  • - page access token

9. Site web (blog)

Stack

  • Framework : Next.js
  • (ou Nest.js si API backend séparée)

Fonctionnement Publication dans le blog du site

  • - récupération des articles via API Strapi
  • - génération des pages (SSR ou SSG)Publication en encart en fonction des labels dans les pages dédiées

SEO

  • - gestion des tags
  • - slug optimisé
  • - meta description

Conclusion Ce type d’architecture reste volontairement simple, mais pose des bases solides : centralisation du contenu, découplage et orchestration par événements.

  • Elle peut ensuite évoluer vers des usages plus avancés (multi-canaux, scoring, personnalisation, automatisation SEO).
  • Si vous travaillez sur ce type de sujets, je serai intéressé d’échanger sur vos architectures ou vos contraintes.

Pierre-Marie Esposito